서명된 계약서 속 2조 달러, 아무도 못 꺼낸 이유는 표였다
기업이 이미 협상해 서명까지 마친 계약 조건이 PDF 속 표 안에 갇혀 아무도 다시 꺼내 쓰지 못하고 있다. Docusign과 NVIDIA는 이 문제가 범용 VLM이 아니라 표 추출에 특화된 작은 모델로 풀린다고 말한다.
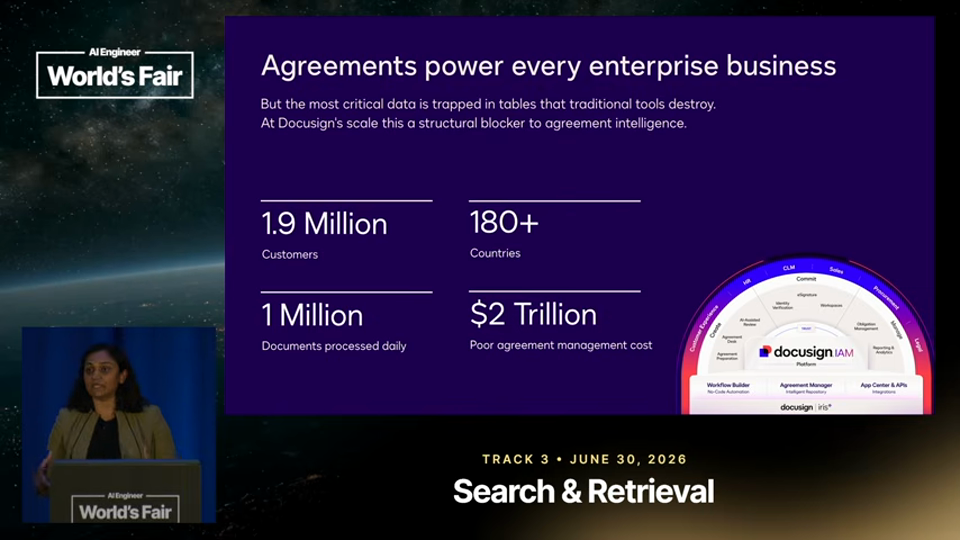
- 규모의 문제 — Docusign은 유료 고객 190만 곳, 사용자 10억 명, 하루 처리 계약 약 100만 건 규모다.
- 방치된 2조 달러 — Deloitte와 함께한 연구에 따르면 협상된 계약 가치 중 2조 달러가 아무도 다시 자본화하지 못한 채 방치돼 있다.
- 계약은 계층적 — 한 계약이 다른 계약을 지배하고 그 계약이 또 다른 계약을 수정하는 식이라 단순한 질문 하나에 답하려 해도 10~20년치 문서를 거슬러 올라가야 한다.
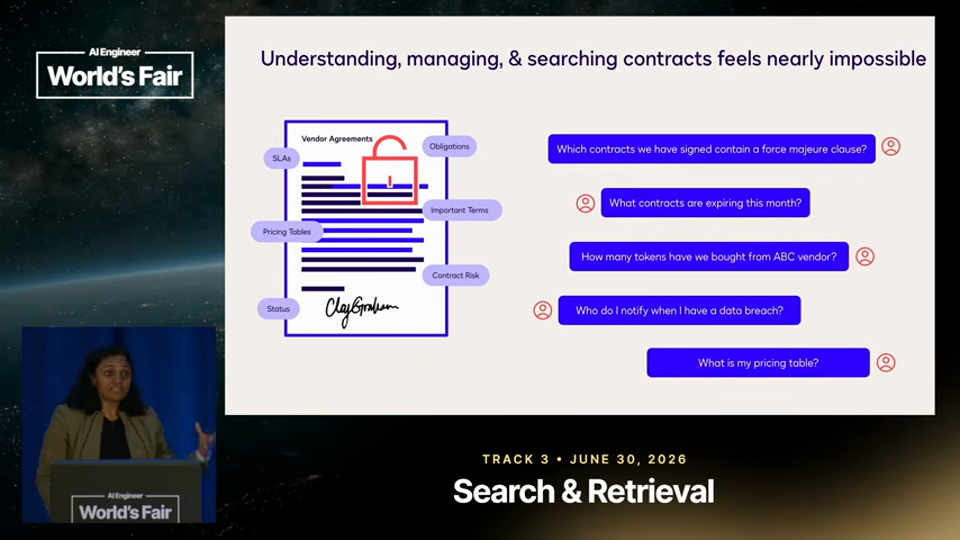
- 진짜로 깨지는 지점 — 가격 등급표, SKU, SLA, 요율표 같은 핵심 조건은 표 형식으로 존재하는데, 일반 문서 추출 도구나 범용 VLM은 텍스트를 줄 단위로 읽어 병합 셀과 경계 구조를 깨뜨려 여기서 완전히 실패한다.
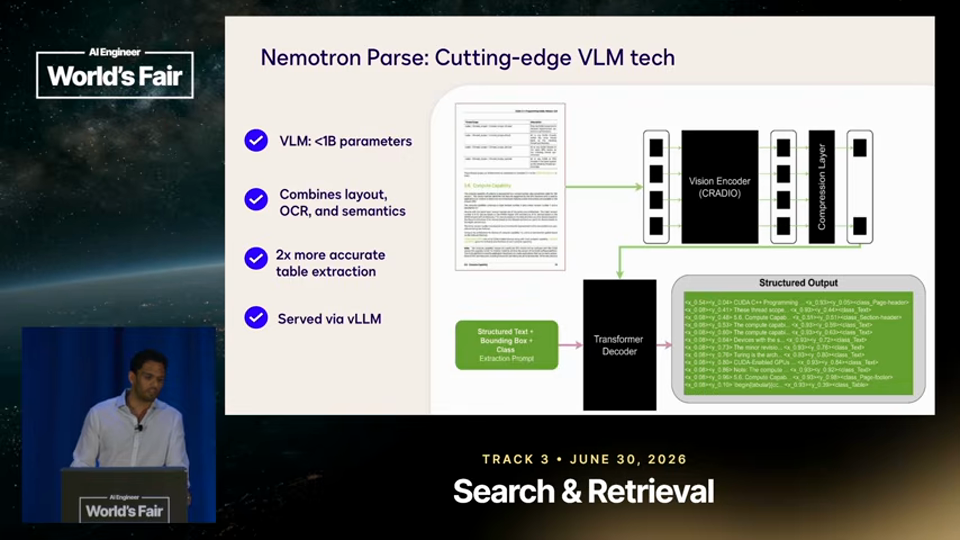
- Nemotron Parse 모델 — NVIDIA와 함께 만든 모델은 약 8억5000만~9억 파라미터의 작은 VLM으로, 생성기가 아니라 추출기로 설계됐으며 레이아웃·텍스트·읽기 순서·표 구조를 한 번의 패스로 뽑아낸다.
- 기존 스택 대체 — 이 모델은 표 추출용 YOLOX 같은 별도의 소형 모델 여러 개를 두는 대신 문서를 넣으면 한 번에 시맨틱 포맷·레이아웃·읽기 순서·보존된 표 구조가 나오는 단일 모델로 대체한다.
- 벤치마크 — RD Table Bench 기준으로 인기 오픈소스 모델들과 비교했으며 Nemotron Parse는 계속 파레토 곡선(정확도 대 성능)을 개선하는 방향으로 릴리스되고 있다.
- 데모 — 주문서를 Agreement Manager에 업로드하면 수 초 안에 핵심 조건과 가격 표가 구조화돼 CSV·API로 다운로드 가능한 형태로 나온다.
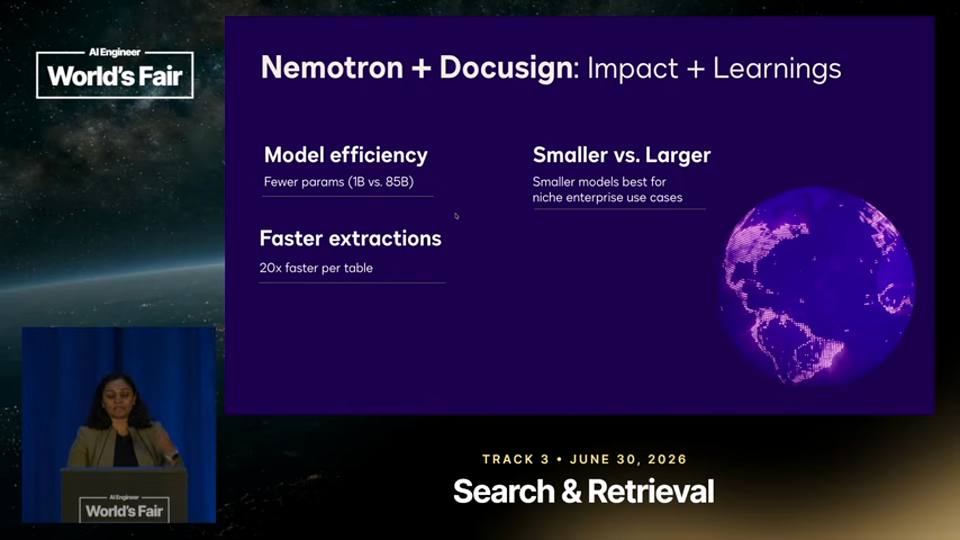
- 20배 빠른 추출 — 초당 추출 가능한 표 개수를 기준으로 다른 오픈소스 모델과 비교했을 때 Nemotron은 20배 빨랐다.
- 작은 모델이 곧 낮은 지연 — 파라미터 수가 작다는 것은 컨텍스트가 작다는 뜻이고, 이는 곧 Docusign이 다루는 규모에서 더 낮은 지연과 더 낮은 비용으로 이어졌다.
- OCR은 유지 — 표는 레이아웃 이해와 함께 추출하지만 다른 필드와 메타데이터, 나머지 텍스트는 여전히 OCR로 처리하는 하이브리드 파이프라인이며, 두 개의 다른 경로로 나뉘어 작동한다.
- 양자화 로드맵 — 모델은 현재 FP16으로 운영 중이며 향후 몇 달 안에 FP8, NVFP4로 옮겨가는 경로를 검토하고 있고, 현재는 한 번에 토큰 하나씩 생성하지만 멀티 토큰 생성으로 추가 최적화할 여지가 있다.
- 다음 단계 — 두 팀은 이제 페이지 안에서 정보를 최대한 뽑아내는 문제에서, 애초에 그 페이지를 찾아내는 문제로 협업 범위를 넓혀 Nemotron Retriever와 NVIDIA 에이전트 툴킷 작업으로 확장할 계획이다.
그가 한 말
이 계약서들 안에 갇혀 협상된 가치가 2조 달러에 달하는데, 아무도 그것을 자산화하지 못하고 아무도 그 데이터를 다시 찾아가지 않습니다.there's $2 trillion captured in this agreement negotiated value that no one capitalizes no one goes back and gets that um data back right2분 1초
전통적인 문서 추출 도구나 범용 VLM/LLM은 여기서 완전히 실패합니다. 저희도 시도해봤는데, 텍스트를 한 줄씩 읽다 보니 테이블 안의 구조 개념이 많이 깨지기 때문입니다.traditional document extraction tools or a generic VM BLM completely fail here like you know we've tried we've definitely done this because they're reading text line by line which breaks a lot of that concept within the table.3분 58초
이건 아주 작은 소형 C-Radio VLM입니다. 약 8억5천만~9억 개의 파라미터를 가진 모델입니다.This is a very small tiny C radio VLM. It's about 850 900 million parameter model.7분 5초
Neotron이 20배 더 빨랐고, 이는 저희가 수백만, 수십억 규모로 고객을 서비스할 때 도움이 됩니다.Neotron was 20x faster which helps us when we're talking about the millions and billions of scale that we're kind of serving for all of our customers.12분 1초
이해관계 · 발화자 두 명은 각각 Docusign(Agreement Manager 제품)과 NVIDIA(Nemotron Parse 모델)의 담당자로, 두 회사가 공동 개발한 자사 제품을 소개하는 발표다.
덧붙임 — 여기에 하나 덧붙이면, "20배 빠르다"는 수치는 비교 대상 오픈소스 모델의 이름이나 조건이 발표에서 구체적으로 공개되지 않아 검증이 어렵다. 그럼에도 900M급 소형 모델이 표 추출이라는 좁은 과업에서 범용 VLM 스택 전체를 대체했다는 설계 판단 자체는, "크게 만들지 말고 좁게 만들라"는 방향성을 보여주는 사례로 읽을 만하다.
오늘 밤 해볼 수 있는 한 가지
회사 계약서나 주문서 PDF 한 건을 골라 표(가격표·SLA) 부분만 직접 LLM에 붙여넣고 구조화된 JSON으로 뽑아달라고 시켜본 뒤, 병합 셀이나 중첩 열에서 실제로 어디가 깨지는지 확인해보라.