1억개 영상서 6초 뒤 정치색 감지, Meta는 프론티어 모델을 안 쓴다
Meta의 숏폼 영상 파이프라인은 1억 개가 넘는 영상에서 모달리티 불일치와 비독창적 콘텐츠라는 두 문제를 다룬다. 이 발표가 뒤집는 통념은 "더 큰 프론티어 모델이 정답"이라는 가정이다. 실제로는 코딩도 못 하는 작은 전문 VLM 세 개가 에이전트로 나뉘어 이 문제를 처리한다.
- 데이터의 실상 — 1억 개 이상 규모에 다국어 텍스트, 적대적 업로드, 드리프트가 섞여 있고 명확한 그라운드 트루스가 없다
- 두 문제 정의 — 스포츠 영상이 6초 지나면 정치색으로 바뀌는 모달리티 불일치, AI 툴로 쉬워진 콘텐츠 복제로 인한 어트리뷰션 붕괴
- 모달리티 간 vs 내부 — 이미지·비디오·오디오·텍스트 간 불일치는 클립 모델 코사인 유사도로 이미 풀린 문제지만, 한 모달리티 내에서 시간에 따라 바뀌는 문제는 아직 풀리지 않았다
- 3 — 에이전트 구조 — 리뷰어가 오케스트레이터 역할을 하고 퍼시버·리트리버 에이전트와 협업하는 멀티에이전트 시스템
- 퍼시버 에이전트 — 고정 프레임레이트가 아니라 시간적 변화가 일어나는 지점에서 영상을 나누고 클립 임베딩·태그·OCR을 뽑아낸다
- 리뷰어의 탐지 — 6초까지는 스포츠였다가 6~6.5초 구간에서 정치적 내용으로 바뀌는 지점을 메타데이터만으로 포착한다
- 리트리버 인덱싱 — 토픽은 역색인, 임베딩은 벡터 DB, 엔티티는 그래프 DB로 나눠 저장해 유사 클립과 저자를 온라인 추론 시 검색한다
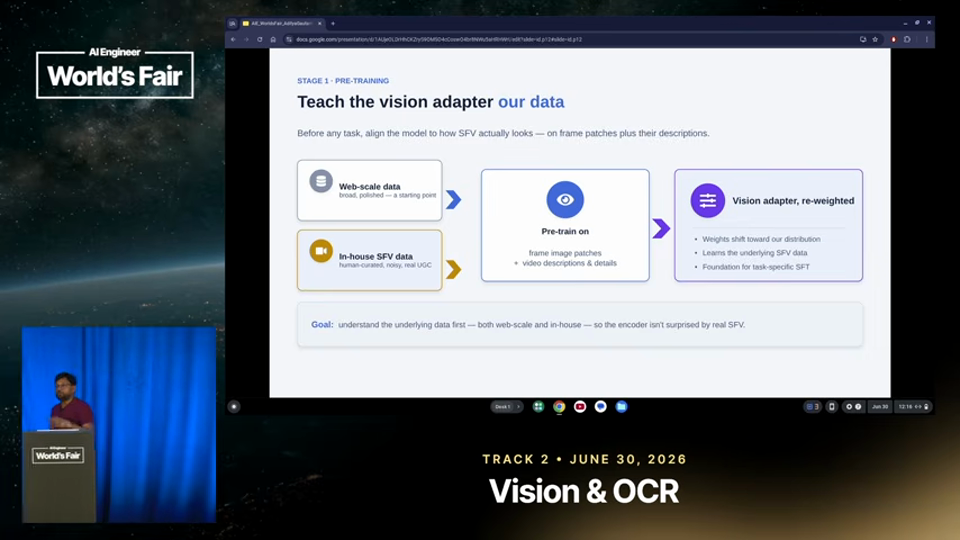
- 사전학습 — 프론티어 모델은 깨끗한 웹 데이터로 학습되지만 사용자 생성 콘텐츠는 그렇지 않아 비전 인코더를 자체 데이터로 처음부터 다시 사전학습한다
- 인스트럭션 파인튜닝 — JSON 스키마 형태의 출력과 정책·가이드라인에 맞춰 모달리티 불일치·중복 점수·추론 과정을 학습시킨다
- DPO 루프 — 프로덕션 샘플을 인하우스 LLM 저지와 휴먼 리뷰 큐로 걸러 95% 같은 임계값 미달 시 어느 툴콜이나 리트리벌 단계에서 실패했는지 추적한다
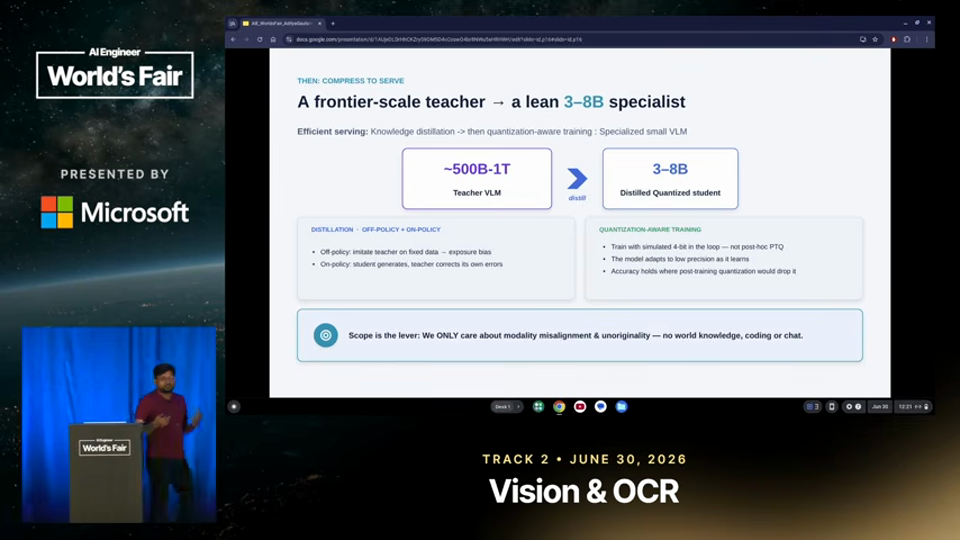
- 증류와 양자화 — 코딩 능력이 필요 없는 도메인 특화 문제이므로 프론티어 크기 모델 대신 오프/온폴리시 증류와 양자화로 모델 크기 테이블을 만든다
- 360도 평가 — 정밀도·재현율을 넘어 노드별 지연시간, 추론 예산, 토큰 비용, LLM 저지의 드리프트까지 함께 본다
- 최적화 3종 — 시공간 압축, 바이럴 콘텐츠 캐싱, 고신뢰 크리에이터를 걸러내는 메타데이터 프루닝으로 파이프라인 전체 처리량을 줄인다
그가 한 말
실제 데이터는 매우 지저분합니다. 우리는 1억 개 이상 규모에서, 그것도 바이럴 콘텐츠가 훨씬 더 많은 상황에서 이야기하고 있습니다.So the real life data is very messy. It is we are talking about at a scale of 100 million plus and a lot more viral content.1분 18초
외부에 나와 있는 이런 VLM들, 파운데이션 모델이나 프런티어 모델들은 매우 깨끗하고 잘 정제된 웹 데이터로 학습되지만, 특정 목적을 위한 사내 데이터는 그런 특성을 전혀 가지고 있지 않습니다.Uh the thing is that these VLMs what we have outside and available the foundational model the front end models they are trained on a very clean very nice data set very web data which is very well tuned cleaned and everything but uh data inhouse for a specific purpose is not having the same data characteristics.10분 51초
조금 비용이 들긴 하지만, 만약 그것이 성능 개선(델타)을 만들어낼 수 있다면 실제로 아주 잘 작동합니다.It's little expensive but um it if if it can get a delta that that actually works really well.11분 30초
저는 모델이 코딩 문제를 풀 수 있는지는 전혀 신경 쓰지 않습니다. 제가 신경 쓰는 건 오직 제 도메인에 특화된 문제뿐입니다.I really don't care if the model can solve a coding problem. I only care about my domain specific problem.16분 10초
이해관계 ·
덧붙임 — 여기에 하나 덧붙이면, 이 설계의 핵심은 "고객에게 노출되지 않는 내부 문제는 프론티어 모델이 아니라 작고 특화된 모델로 푼다"는 비용 판단이다. 코딩 능력 같은 범용성을 포기하는 대신 도메인 데이터로 처음부터 사전학습하고 DPO로 계속 보정하는 쪽이 1억 개 규모에서는 더 남는 장사라는 뜻이다.
오늘 밤 해볼 수 있는 한 가지
본인이 다루는 파이프라인에서 프론티어 모델을 쓰고 있는 내부 단계 하나를 골라, 그 작업에 정말 코딩·범용 추론 능력이 필요한지 30분 동안 따져보고 작은 특화 모델로 대체 가능한지 표로 정리해본다.