KV캐시 4비트 압축, 데이터센터에선 TPS 반토막 낸다
Baseten의 Philip Kiely는 2월 출간한 책 'Inference Engineering' 이후 불과 몇 달 사이 벌어진 변화를 정리했다. 20억 회 이상 노출되며 메모리 반도체 주가까지 흔든 TurboQuant 열풍의 실체를 팀이 직접 계산해보니, 로컬 환경에는 이상적이지만 데이터센터에는 쓸 수 없는 기술이었다. 그는 이 사례를 통해 로컬 추론과 데이터센터 추론이 서로 다른 문법으로 움직인다는 점, 그리고 추론 최적화가 점점 별도의 학습 과정에서 나온다는 점을 짚었다.
- 책과 반응 — 2월 23일 출간 후 종이책 1만1000부, 디지털 3만부, 트위터 노출 2400만 계정을 기록했다
- 두 세계의 분기 — 로컬 추론은 '작동시킨 뒤 덜 멍청하게', 데이터센터 추론은 '작동시킨 뒤 덜 느리게'가 원칙이다
- 학습과 추론의 경계 — 최근 추론 최적화 상당수가 전용 학습 과정에서 나오면서 훈련과 추론의 경계가 흐려지고 있다
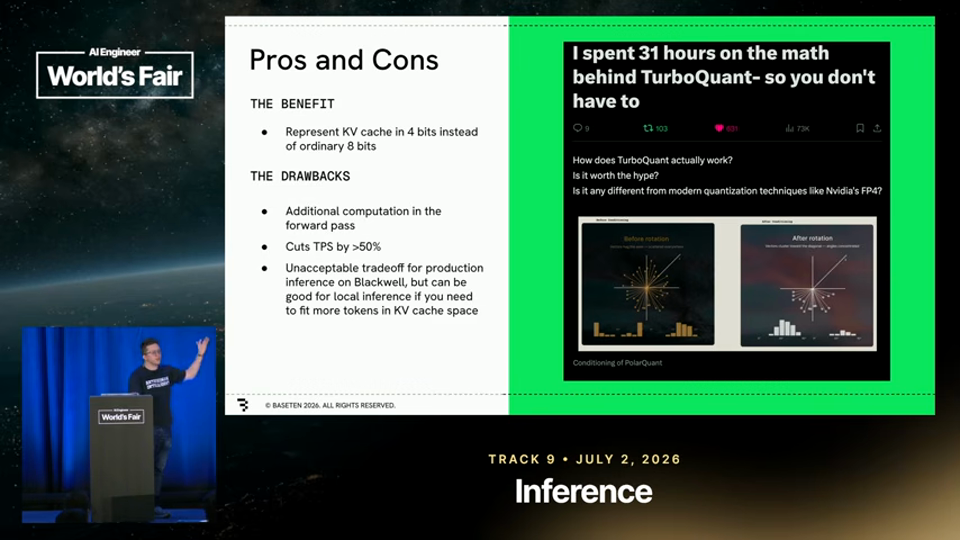
- TurboQuant 화제 — 극좌표 기반 양자화로 KV캐시를 4비트까지 줄이는 이 기법이 3월 화제가 되며 메모리 반도체 주가를 잠깐 떨어뜨렸다
- TurboQuant의 함정 — 밴드폭은 2배로 늘지만 디코드 시 추가 연산이 필요해 TPS가 절반 이하로 떨어진다
- 데이터센터의 선택 — Baseten은 TurboQuant 대신 여전히 NVFP4로 가중치를 양자화하는 방식을 쓴다
- 로컬에는 최적 — 메모리가 병목인 로컬 환경에서는 TurboQuant의 트레이드오프가 오히려 유리하다
- KV 압축(Still) — Baseten 자체 개발한 Still은 학습된 병목 구조가 고정 쿼리 벡터로 전체 KV캐시를 크로스어텐션해 한 번의 forward pass로 압축된 키·값을 만든다
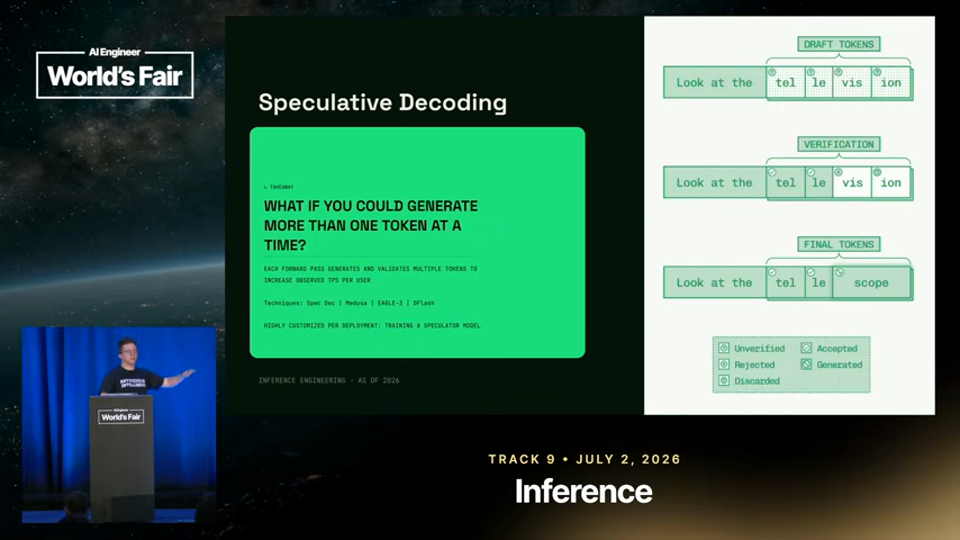
- 추측 디코딩 역사 — 같은 계열의 소형 모델로 드래프트 토큰을 만드는 방식(Spec)은 성능이 나빴고, Eagle3가 타깃 모델의 hidden state를 학습해 이를 크게 개선했다
- Dllash 등장 — 디퓨전 기반 드래프터 Dllash는 한 번의 forward pass로 8~16개 토큰을 한꺼번에 제안한다
- 3배 개선 — 단일 B200에서 Qwen 38B 기준 Dllash는 기존 최고 기법 대비 채택률과 TPS 모두 3배 이상 개선을 보였다
- DSpark 공개 — 며칠 전 나온 DSpark는 디퓨전 모델과 순차 모델을 함께 써 채택률을 더 높이려 하지만 아직 프로덕션 결과는 없다
- 지속 재학습 — 실시간 프롬프트·응답으로 드래프터 모델을 계속 재학습하면 토큰 채택률이 20%에서 최대 2배까지 향상된다
그가 한 말
인퍼런스 엔지니어링에는 두 종류가 있습니다. 로컬 인퍼런스는 가진 하드웨어에서 일단 돌아가게 만드는 게 압도적인 전략이고, 먼저 작동시킨 다음 덜 멍청하게 만듭니다. 그리고 제가 있는 세계인 배치 사이즈와 데이터센터 세계는 일단 작동시킨 다음 덜 느리게 만드는 것입니다.You know, there's two types of inference engineering that have really emerged. There's local inference where the overwhelming strategy is just get it working on whatever hardware you have by squishing the model... and first you get it working and then you make it less dumb... and then there's my world which is the batch size and data center world where it's get it working... and then make it less slow.2분 28초
최근 들어 점점 더 많이 발견하는 것은, 인퍼런스를 위한 많은 최적화가 전용 훈련 과정에서 나온다는 겁니다. 그래서 훈련과 인퍼런스의 경계가 점점 더 흐려지고 있습니다.What I've found more and more recently is that many optimizations for inference come from a dedicated training process. And so the lines between training and inference are getting blurriier and blurriier.3분 52초
알고 보니 디코딩 중 이를 보정하기 위해 순전파에서 추가 연산이 필요하고, 이는 초당 토큰 수를 절반 이상 깎아먹는데, 이는 많은 프로덕션 사용 사례에서 받아들일 수 없는 트레이드오프입니다.Turns out that you need to do additional computation in the forward pass to account for this during decode and it cuts TPS by more than half and that's just an unacceptable trade-off for a lot of the production use cases.7분 8초
알고 보니 작은 모델들은 드래프트 토큰 생성기로서는 별로 좋지 않았습니다. 그냥 좋은 작은 모델일 뿐이었죠.Turns out that small models are like not great draft token generators. They're great small models.12분 31초
이해관계 · 발화자는 Baseten 소속으로 자사 책 'Inference Engineering'을 무료 배포하며 자사 연구(Still, Dllash 프로덕션 적용 등)를 소개했다.
덧붙임 — 여기에 하나 덧붙이면, TurboQuant 해프리티는 소셜미디어발 기술 화제가 실제 프로덕션 적용 가능성과 얼마나 쉽게 괴리되는지 보여주는 사례다. '학습이 추론을 위해 존재한다'는 흐름이 굳어지면, 추론 엔지니어링 책도 몇 달 단위로 개정판이 필요해질 수 있다.
오늘 밤 해볼 수 있는 한 가지
자신이 쓰는 추론 스택에서 KV캐시가 8비트인지 4비트인지 확인하고, 배치 크기가 1에 가까운 로컬 환경인지 데이터센터급 서빙인지에 따라 양자화 전략을 다르게 가져가야 하는지 점검해보라.