OpenAI, 추론 라우팅서 되먹임 루프 걷어내고 최적화 계산으로 교체
OpenAI 추론 팀이 GPU 엔진에 트래픽을 배분하던 기존의 피드백 루프 방식을 폐기했다. 엔진이 식으면 트래픽을 도로 보내는 진동 문제와 "왜 이 엔진 가중치가 더 높은가"에 답할 수 없던 불투명성이 이유다. 대신 컨트롤 플레인이 전역 최적화를 계산하고 데이터 플레인은 캐시된 스냅샷만 보고 즉시 응답하는 구조로 바꿨다.
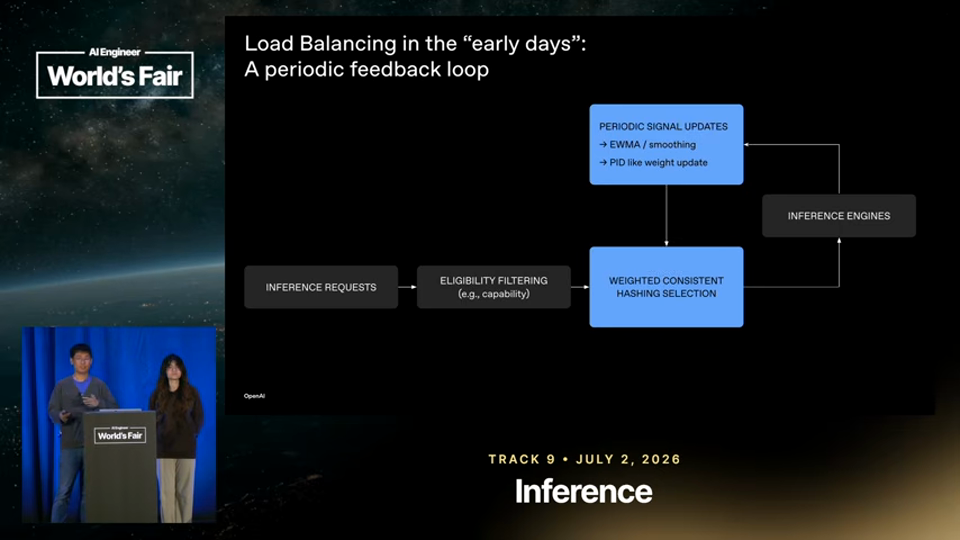
- 초기 구조 — IRB(추론 로드밸런서)는 초기에 엔진이 보고하는 TTFT, 토큰 간 시간, KV 캐시 등 신호를 주기적으로 스무딩해 성능 점수를 만들고 이를 함대 평균과 비교해 가중치를 올리거나 내리는 P 컨트롤러(비례 제어기) 방식이었다.
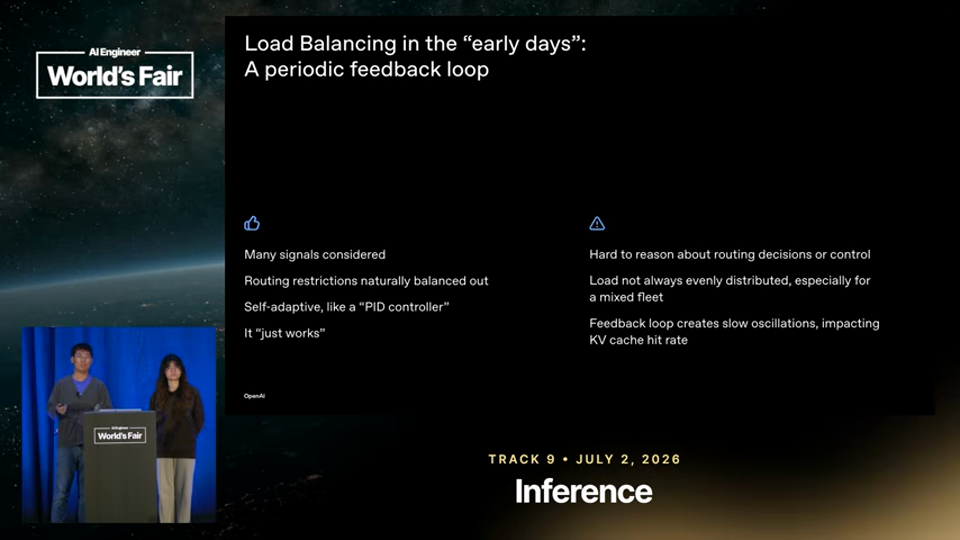
- 자기 균형 장점 — 이 방식은 여러 신호를 하나의 라우팅 결정으로 결합하고, 용량 제약이 있는 엔진은 다음 루프에서 신호가 반영돼 스스로 균형을 맞추는 장점이 있었다.
- 설명 불가능성 — 반면 왜 특정 엔진이 더 높은 가중치를 받았는지 설명하기 어렵고, 한 속성을 조정하면 다른 속성이 영향을 받는 문제가 있었다.
- 진동 문제 — 트래픽을 옮기면 엔진이 식고, 그 냉각 신호를 컨트롤러가 '여유 용량'으로 읽어 트래픽을 되돌리는 진동이 발생해 KV 캐시 지역성을 오히려 해쳤다.
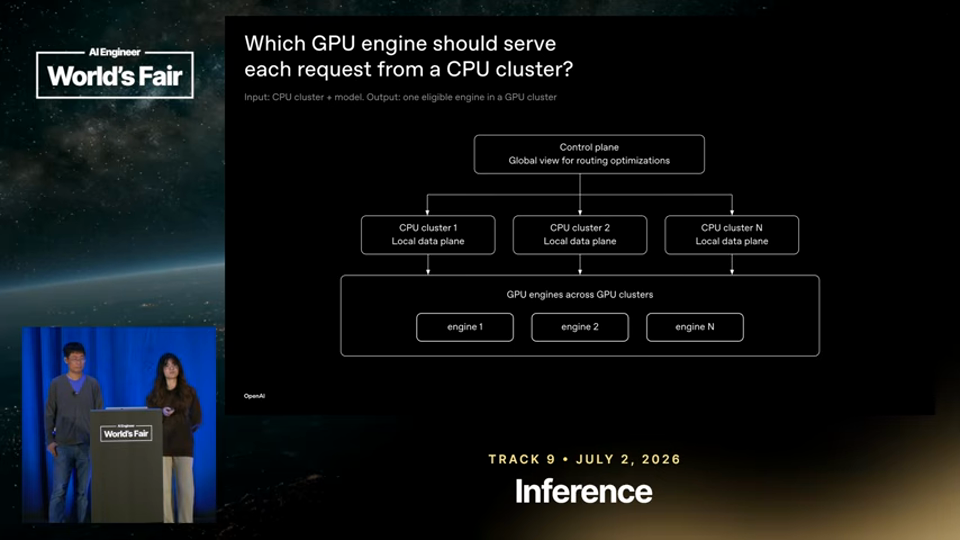
- 새 아키텍처 — 새 구조는 모든 CPU·GPU 클러스터를 전역적으로 보는 컨트롤 플레인과, 각 클러스터에서 어느 엔진이 요청을 처리할지 캐시된 스냅샷으로 즉시 답하는 데이터 플레인으로 나뉜다.
- 세 가지 경로 — 시스템에는 요청 경로(동기, 로컬), 엔진 신호 경로, 라우팅 가중치 경로 세 가지가 있으며 동기적인 것은 요청 경로 하나뿐이다.
- 가장 가까운 엔진의 함정 — CPU 클러스터 B가 120RPS를 보내는데 근처 엔진은 100RPS까지만 처리 가능한 반면, 두 지역 떨어진 엔진은 80RPS 중 40RPS만 쓰고 있어 이 경우 먼 엔진이 종단 지연에서 더 빠를 수 있다.
- 최적화 목표 — 옵티마이저는 네트워크 거리와 엔진 측 대기시간을 모두 포함해 전체 트래픽의 기대 종단 지연을 최소화하는 것을 목표로 한다.
- 제약 조건 — 옵티마이저는 모든 요청을 라우팅해야 하고, 어떤 엔진도 유효 용량을 넘지 않아야 하며, 가중치는 음수가 될 수 없다는 세 가지 하드 제약을 지킨다.
- 입력 데이터 — 옵티마이저는 클러스터별 요청량, 엔진까지의 네트워크 지연, 가용 용량·헬스, TTFT·TBOT 지연 프로파일 네 가지를 입력으로 받는다.
- 장애 대응 페널티 — 이상치로 감지된 엔진은 라우팅 가중치를 낮춰 스스로 회복하거나 사람이 개입할 시간을 벌어준다.
- 재시도 폭풍 방지 — 시스템이 한계에 가까울 때 재시도가 더 많은 부하와 실패를 유발하는 '재시도 폭풍'을 막기 위해 상황에 따라 동적으로 변하는 재시도 예산(캡)을 도입했다.
- 로드 셰딩 — 용량이 수요를 못 따라갈 때 시스템 전체가 무너지는 대신 일부 트래픽을 선제적으로 차단해 우아하게 저하시키는 로드 셰딩을 최후 수단으로 쓴다.
그가 한 말
가중치는 주기적인 피드백 루프에서 생성되었습니다. 추론 엔진들이 우리가 신경 쓰는 온갖 신호를 보고하면, 컨트롤러가 주기적으로 그 신호들을 평활화해서 성능 점수를 계산합니다.So they were generated by a periodic feedback loop. The inference engines as mentioned earlier uh reports all kind of the signals we care about and the controller will periodically smooth out those signals and compute a performance score.4분 7초
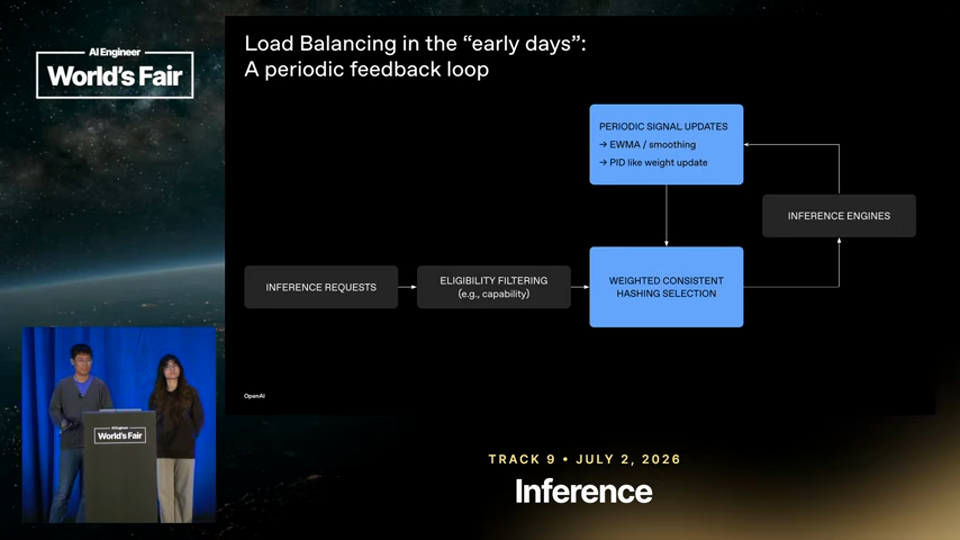
이 P 컨트롤러는 리눅스 프로세스를 관리하는 게 아니라 고전 제어 이론 기법입니다.and no this P controller will not help you care a Linux process but instead it's a classic control theory technique4분 53초
피드백 루프는 때때로 나쁜 진동을 만들어냅니다. 트래픽을 엔진에서 빼면 그 엔진이 조금 식는데, 이 신호가 컨트롤러에 들어가면 컨트롤러는 이 엔진이 트래픽을 훨씬 더 받을 수 있다고 판단합니다. 그러면 트래픽이 몇몇 엔진 사이를 왔다 갔다 하면서 KV 캐시 활용도를 망가뜨립니다.the feedback loop sometimes creates bad oscillations because when you shift an engine away some traffic the engine turns a bit cooler and this signal get fit to the controller. The controller now thinks that hey this engine can take a lot more traffic. then the some traffic going to be shifted back and forth between a few engines and disrupting the KV cache utilization.6분 35초
여러 CPU 클러스터가 독립적으로 같은 엔진에 트래픽을 보내면 그 엔진은 과부하되고 다른 엔진들은 활용도가 낮은 상태로 남을 수 있습니다.Multiple CPU cluster route traffic to the same engines independently which could overload that engine while leave other engines underutilized.8분 26초
이해관계 · 발화자 두 명 모두 OpenAI 추론 팀 소속으로, 자사가 운영하는 추론 인프라 시스템을 발표했다.
덧붙임 — 여기에 하나 덧붙이면, 피드백 루프의 실패는 결국 '관찰 가능한 상태'와 '제어 대상 상태'가 같은 신호를 공유할 때 생기는 순환 논리의 문제다. 컨트롤 플레인과 데이터 플레인을 분리한 것은 라우팅 결정 속도(동기)와 최적화 계산 속도(비동기)를 분리해 이 순환을 끊은 설계로 볼 수 있다.
오늘 밤 해볼 수 있는 한 가지
자신이 운영 중인 다중 인스턴스 서비스에서 로드밸런싱 가중치가 어떤 신호로 갱신되는지 점검하고, 그 갱신 주기가 실제 트래픽 변화 속도보다 느려 진동을 일으키는 구간이 있는지 로그로 확인해본다.