200 QPS 요청했는데 38 QPS, 벤치마크 툴이 거짓말한다
LLM 서빙 성능이 나쁘다고 진단할 때, 실제 문제는 서버가 아니라 벤치마크 하네스 자체인 경우가 많다. Google의 Ashok Chandrasekar와 Jason Kramberger는 Python 단일 프로세스 하네스가 요청한 부하를 몰래 못 채우면서도 다 채운 것처럼 결과를 찍어낸다는 사실을 발견했고, 이를 해결하는 CNCF 프로젝트 Inference Perf를 공개했다.
- 벤치마크 생태계 — 모델 서버 프레임워크, 경쟁 분석 툴(MLPerf, SemiAnalysis, Artificial Analysis), 웹 벤치마크(Locust, Grafana k6)로 나뉘며 이 발표는 그중 프로덕션 규모 LLM 벤치마크에 초점을 맞춘다.
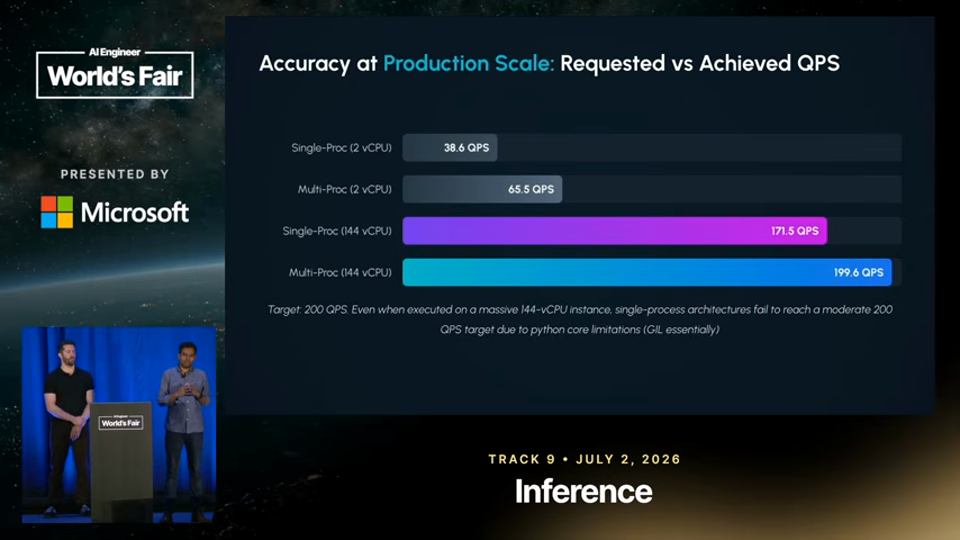
- 200 요청했는데 38 — 작은 4코어 머신에서 200 QPS를 요청했지만 실제로는 38 QPS만 나왔고, 더 강력한 머신에서도 단일 프로세스 하네스는 170 QPS 부근에서 상한에 걸렸다.
- GIL이 원인 — Python의 GIL(global interpreter lock) 때문에 멀티코어 머신에서도 단일 프로세스 하네스는 CPU 하나의 성능에 묶인다.
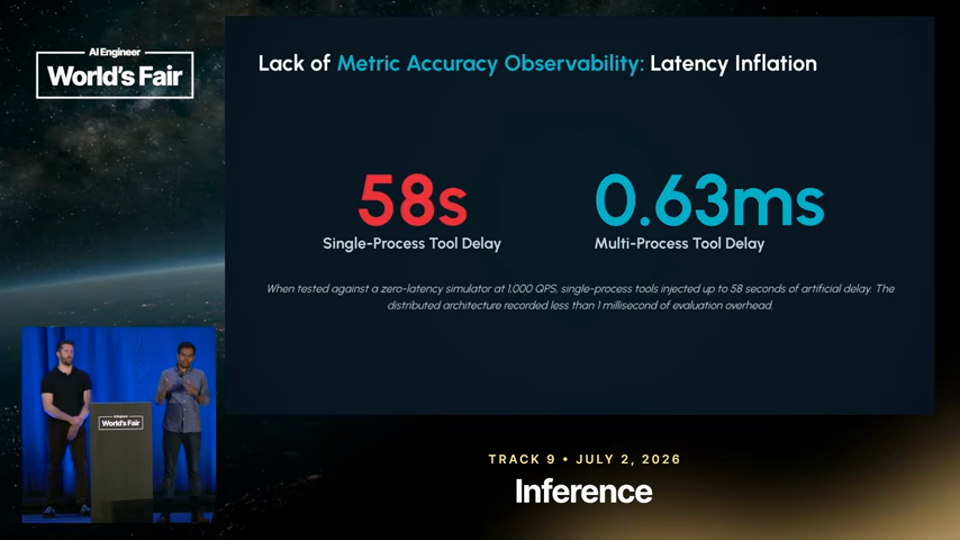
- 지연시간 부풀리기 — 하네스가 스트리밍 토큰 수집으로 허덕이면서 지연시간을 최대 58초까지 부풀린 사례가 있었고, 이는 서버가 아니라 클라이언트 문제였다.
- temperature 조작 — 20% 더 높은 처리량을 자랑한 공유 벤치마크는 실제로는 temperature를 0으로 설정해 만든 결과였고, 실제 워크로드의 temperature 0.7보다 훨씬 결정론적이고 빠르게 나온 것이었다.
- 같은 데이터셋, 다른 결과 — 동일한 ShareGPT 데이터셋을 두 하네스에 넣었는데도 샘플링과 truncation 방식이 달라 입력 토큰 수가 서로 다르게 나왔다.
- Inference Perf 소개 — Kubernetes serving 워킹그룹에서 나온 CNCF 프로젝트 Inference Perf로 이 문제들을 해결하려 했다.
- 멀티프로세스 구조 — 메인 프로세스가 요청을 계획된 실행 시각에 맞춰 큐잉하고 여러 워커 프로세스에 분산시키며, 각 요청이 실제로 언제 실행됐는지 계획 시각과 비교해 보고한다.
- 5000 QPS에서 검증 — k6 등 다른 HTTP 스케일 툴과 비교했을 때 5,000 QPS에서도 Inference Perf는 부하를 따라잡았고 그 사실을 스스로 보고했다.
- 선언형 설정과 워크로드 카탈로그 — 입출력 길이 분포까지 지정해 멀티턴 대화를 재현할 수 있는 선언형 설정을 제공하며, multi-turn 생성·tree of thought·agentic generation·batch summarization 등을 정의한 공개 워크로드 카탈로그를 만들었다.
- Prism으로 결과 공유 — LLMD 프로젝트의 UI인 Prism에서 8개 레플리카 프로덕션 규모의 agentic code generation 워크로드 결과를 보여주며 최적화 조합이 기준선 대비 초당 수십만 토큰까지 확장되는 것을 확인했다.
그가 한 말
코어 수가 적은 머신에서 돌리면 200 QPS를 요청해도 실제로는 38 QPS밖에 못 냅니다. 더 강력한 머신을 줘도 일부 싱글 프로세스 하네스는 170 QPS 정도에서 한계에 부딪힙니다.when you run with a really uh small shad core mission, you can see that even when you request 200 QPS, you are only getting 38 QPS and then you give it a bigger mission and then some of these uh single process harness they cap out at like 170 QPS5분 49초
한 테스트에서는 지연이 58초까지 발생했습니다. 이걸 보면 서버가 병목이라고 생각하겠지만, 실제로는 벤치마크 클라이언트가 지연을 부풀리고 있는 것입니다.in one of the tests we noticed like u the delay was up to 58 seconds. So you might look at this and go oh my server is bottlenecked right it's not able to handle all the requests but in fact it's actually your benchmark client that is inflating the latency6분 38초
'저희는 처리량이 20% 더 좋습니다'라고 했는데, 조사해보니 벤치마크 하네스가 모델 온도를 0으로 설정해 놓았던 것이었습니다.they said, "Hey, we are getting 20% better throughput." Then we looked into it and we found out the benchmark harness were setting the model temperature to zero7분 12초
많은 경우 서버나 추론 스택 문제라고 진단하지만, 사실 많은 경우 문제는 벤치마크 하네스 자체에 있을 수 있습니다.a lot of times you diagnose it as a your server or inference stack problem but in a lot of cases it could be your benchmark harness8분 16초
이해관계 · 발화자들은 Google 소속이며 발표에서 소개한 Inference Perf, LLMD, LLMD Prism 등 오픈소스 프로젝트의 메인테이너 또는 SIG 리드로 참여하고 있다.
덧붙임 — 여기에 하나 덧붙이면, 이 문제는 LLM 서빙에만 국한되지 않는다 — 부하 테스트 툴 자체가 목표 부하를 달성했는지 검증하지 않고 결과만 뱉는 관행은 다른 시스템 벤치마크에서도 흔하다. 벤치마크 숫자를 볼 때는 항상 "이 클라이언트는 자기가 실패했는지 알고 있었는가"를 먼저 물어야 한다.
오늘 밤 해볼 수 있는 한 가지
지금 쓰고 있는 벤치마크 하네스로 목표 QPS를 요청한 뒤, 실제로 몇 QPS가 나왔는지(요청 대비 실제 처리량)를 로그에서 직접 대조해보라 — 하네스가 그 차이를 스스로 보고하지 않는다면 그 결과는 신뢰할 수 없다.