RMS norm는 연산량 1할인데 왜 33번 호출로 속도를 갉아먹나
RMS norm은 트랜스포머 전체 연산량에서 차지하는 비중이 거의 없는 층이다. 그런데도 디코드 한 스텝에 33번씩 호출되며 GPU를 계속 멈춰 세운다. Filip Makraduli는 Nils Graef와 함께 이 층을 손대는 대신 계산 순서만 바꿔 33~35%의 속도를 벌어내는 FlashNorm을 만들었고, 그 과정에서 모델이 거꾸로 말하게 만든 CUDA 버그를 직접 잡았다.
- 문제 정의 — RMS norm은 연산량 비중은 작지만 한 디코드 스텝에서 최대 33번 호출된다
- GPU의 약점 — GPU는 수학은 빠른데 작업 시작, 데이터 이동, 대기에는 느리다
- 제안 1: 웨이트리스 정규화 — norm의 게인을 프로젝션 가중치에 오프라인으로 접어 넣어 행렬 하나로 만든다
- 제안 2: 지연된 정규화 — 스칼라 나눗셈을 미뤄 행렬 유닛과 벡터 유닛을 동시에 돌린다
- 제안 3: 이중 정규화 제거 — Gemma 4처럼 RMS norm이 두 번 연속되는 구조에서는 스케일 불변성 때문에 하나를 지워도 된다
- 성능 결과 — 세 가지 트릭을 합치면 norm과 프로젝션 연산에서 33~35%의 속도 향상이 난다
- 구현 난이도 — 제안 1은 Transformer Tricks 저장소의 flashify로 바로 적용되지만 제안 2는 커널 작업이 필요하다
- 실제 버그 — CUDA로 텐서 코어의 행렬곱과 CUDA 코어의 RMS 리덕션을 병렬로 돌리자 긴 생성에서 한 스텝 지연된 반복이 나타났다
- 원인 — 두 스트림의 join이 암묵적이어서, 한 스트림이 끝나기 전에 post scale이 완료되지 않은 곱셈의 오래된 버퍼를 읽는 경쟁 조건이 발생했다
- 수정 — 행렬곱과 RMS 각각의 끝을 명시적으로 마킹하고 post scale이 두 스트림을 모두 기다리게 하자 버그가 사라졌다
- 호환성 — 폴딩된 체크포인트는 torch compile과 양자화 모델에서도 그대로 동작한다
- 배포 — Superlinked의 오픈 추론 엔진으로 커스텀 체크포인트를 클러스터에 올려 이런 연구 아이디어를 직접 테스트할 수 있다
그가 한 말
왜 RMS norm이냐, 그 레이어는 연산의 거의 대부분을 차지하지 않는데? 맞는 말입니다.why RMS norm since that layer does almost none of the math? And that's true.2분 1초
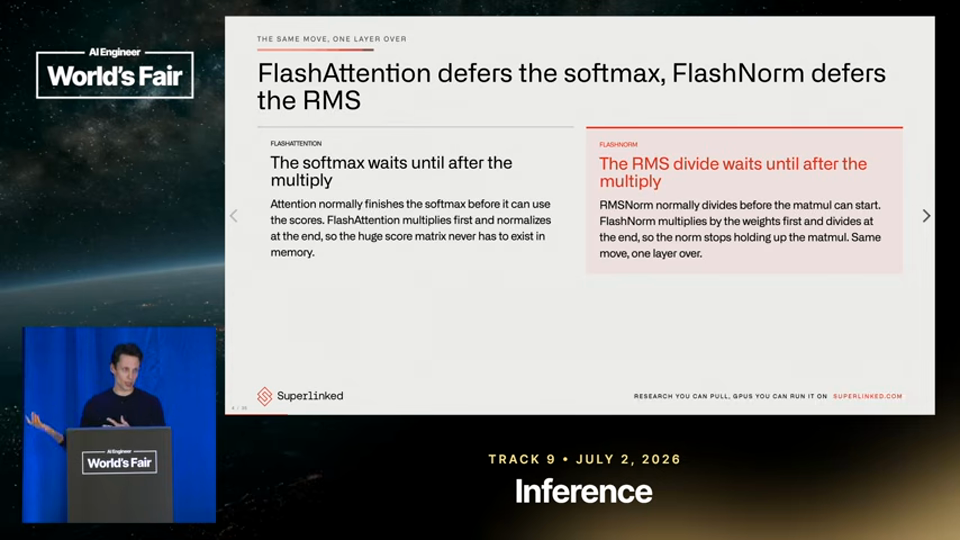
디코드 스텝 하나에서, 즉 추론이 수행될 때 RMS norm이 33번 정도 시작될 수 있습니다.in one decode step. So right when like inference is performed the RMS norm can be started like 33 times.2분 25초
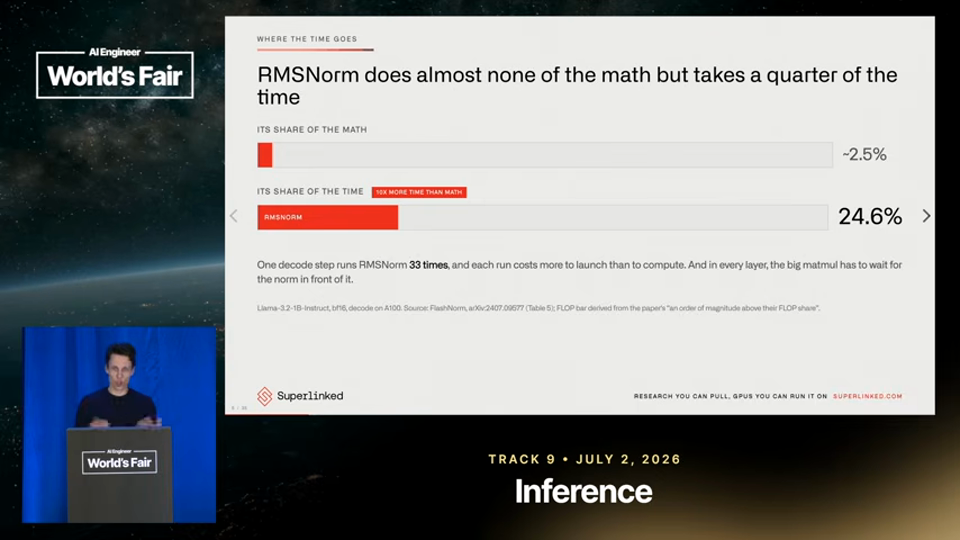
두 스트림 중 하나가 작업을 끝내지 못한 상태에서, 끝나지 않은 행렬곱에서 과거 값을 읽어오는 경쟁 조건이 발생했습니다.one of the streams hadn't finished the work, so I got race conditions that kind of read the past from the unfinished matrix multiplication.9분 8초
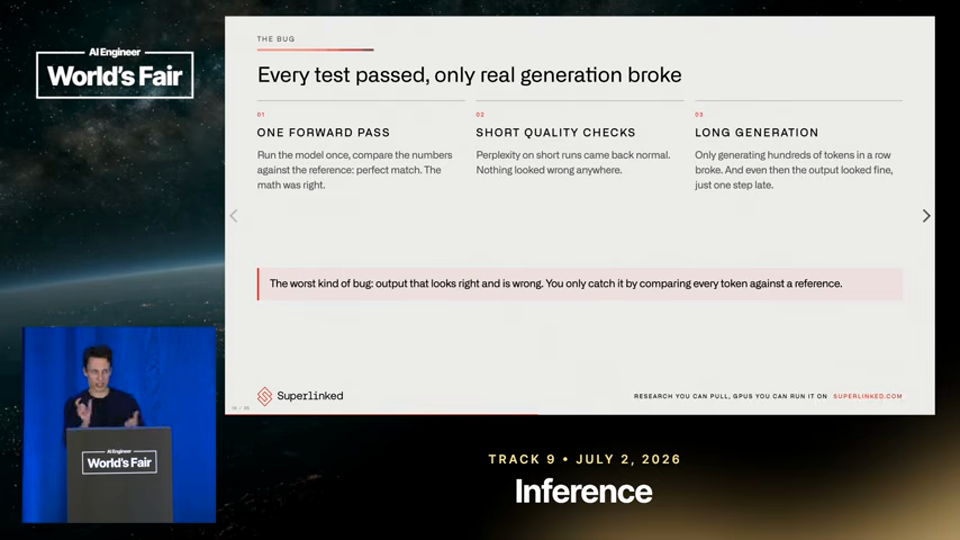
그렇게 하니 버그가 고쳐졌고, 논문의 기법이 실제로 작동하며 모델이 거꾸로가 아니라 제대로 말하게 되었습니다.That fixed the bug and made kind of the paper work and the model speak forwards instead of backwards.10분 12초
이해관계 · 발화자는 발표 말미에 자신이 활용한 Superlinked의 오픈 추론 엔진(사이트/클러스터)을 소개하며 관련 생태계를 언급했다.
덧붙임 — 여기에 하나 덧붙이면, 이 발표가 흥미로운 지점은 성능 개선 자체보다 "왜 버그가 눈에 안 띄었는가"다. 유닛 테스트와 퍼플렉시티는 정상이었는데 긴 생성에서만 드러났다는 건, GPU 스트림 동기화 버그가 짧은 벤치마크로는 잡히지 않는다는 뜻이다.</note_ko> </invoke>
오늘 밤 해볼 수 있는 한 가지
Transformer Tricks 저장소의 flashify 스크립트를 내려받아, 갖고 있는 작은 Llama 계열 체크포인트 하나에 가중치 폴딩만 적용해보고 추론 속도가 실제로 달라지는지 확인해본다.