1000번에 한 번 vLLM이 헛소리한 이유는 32비트 정수였다
AI21의 Jamba 모델이 vLLM 위에서 아주 가끔, 그것도 높은 확신도로 헛소리를 내뱉는 문제가 있었다. 크래시도, 에러 로그도 없었기에 이는 모델 품질 문제가 아니라 엔지니어링 문제였다. AI21 연구자 Asaf Gardin과 Yuval Belfer는 이 버그를 재현하고 추적해 결국 원인이 스케줄러의 순서 오류와 32비트 인덱스 오버플로라는 것을 밝혀냈다.
- 문제 정의 — 1000개 요청 중 하나꼴로 vLLM에서만, 그리고 부하가 걸릴 때만 Jamba가 높은 확신도로 헛소리를 냈다.
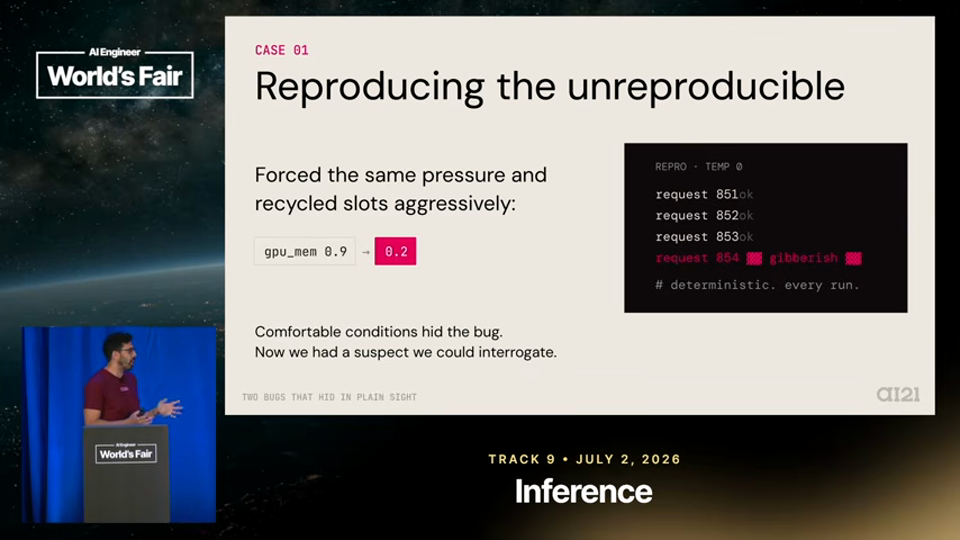
- 재현 트릭 — 프롬프트를 아무리 보내도 재현이 안 되자 GPU 메모리 활용률을 90%에서 20%로 낮추고 temperature 0으로 돌리자 8854번 요청이 매번 헛소리를 냈다.
- 기준선 비교 — Hugging Face transformers의 순정 forward pass를 기준선으로 삼아 vLLM 응답의 logprob과 비교해 분포 발산을 계산했다.
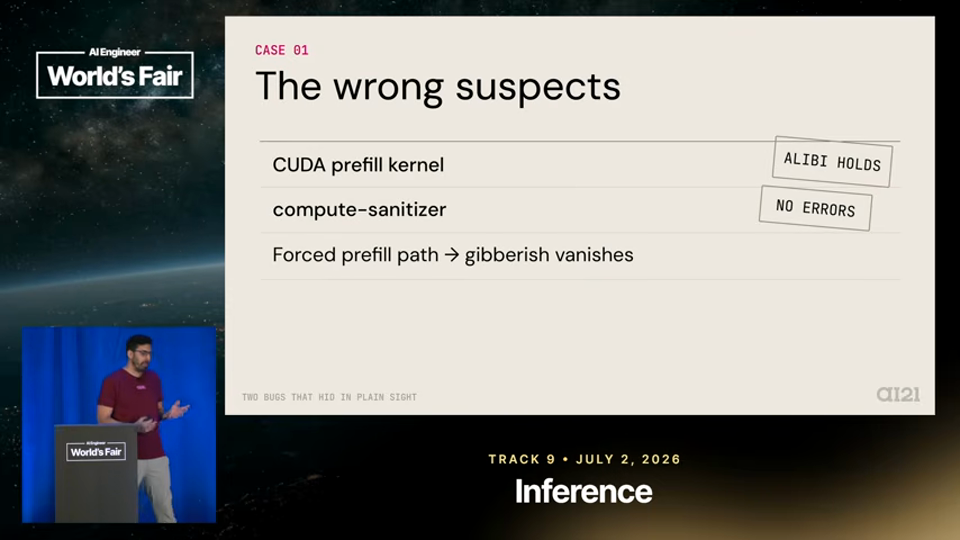
- 첫 번째 오탐 — prefill 커널과 Nvidia compute sanitizer를 검사했지만 문제가 없었고, 디코드 커널을 빼고 전부 prefill로만 돌리자 헛소리가 사라져 디코드 커널을 의심했다.
- 진짜 원인 추적 — forward pass 안에서는 요청에 정체성이 없다는 것을 깨닫고 request ID를 forward context까지 끌고 내려가 문제의 요청에 브레이크포인트를 걸었다.
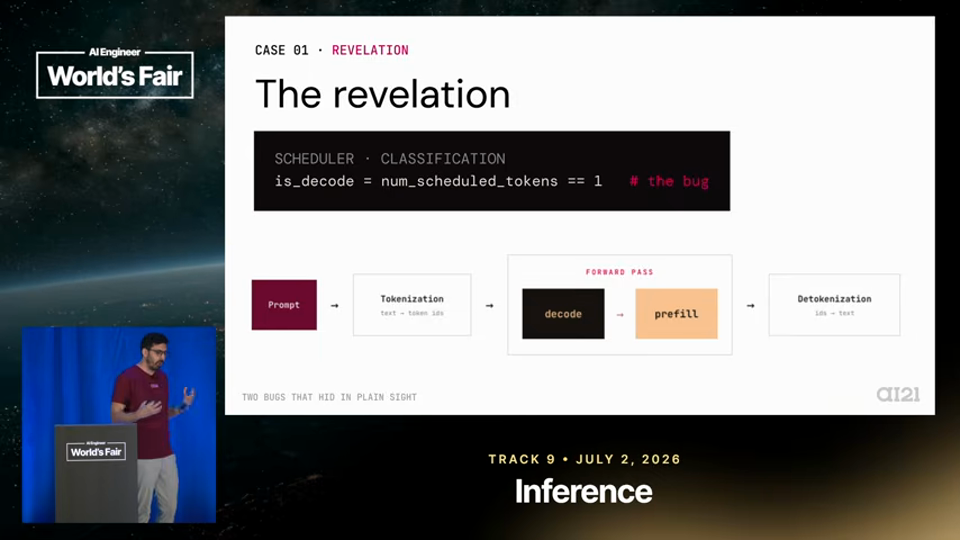
- 스케줄러의 실수 — 스케줄러가 prefill보다 decode를 먼저 실행시켰고, Mamba는 상태를 먼저 읽기 때문에 이전 요청들의 stale한 상태를 그대로 이어받아 계산했다.
- attention과의 차이 — attention은 KV를 먼저 쓰고 나중에 읽기 때문에 순서가 뒤바뀌어도 안전하지만, Mamba는 상태를 먼저 읽으므로 순서 오류에 취약했다.
- 1차 수정 — 토큰이 한 번도 계산된 적 없는 요청을 스케줄러가 prefill로 명확히 표시하도록 코드를 고쳤고 이 패치는 머지됐다.
- 두 번째 사건 — RL 학습 중 가중치 업데이트 전인데도 12스텝마다 logprob이 튀는 현상이 나타났다.
- 레버 실험 — 프롬프트당 롤아웃 수를 8에서 128로 늘리자 스파이크가 12스텝째가 아니라 1스텝째에 바로 나타났다.
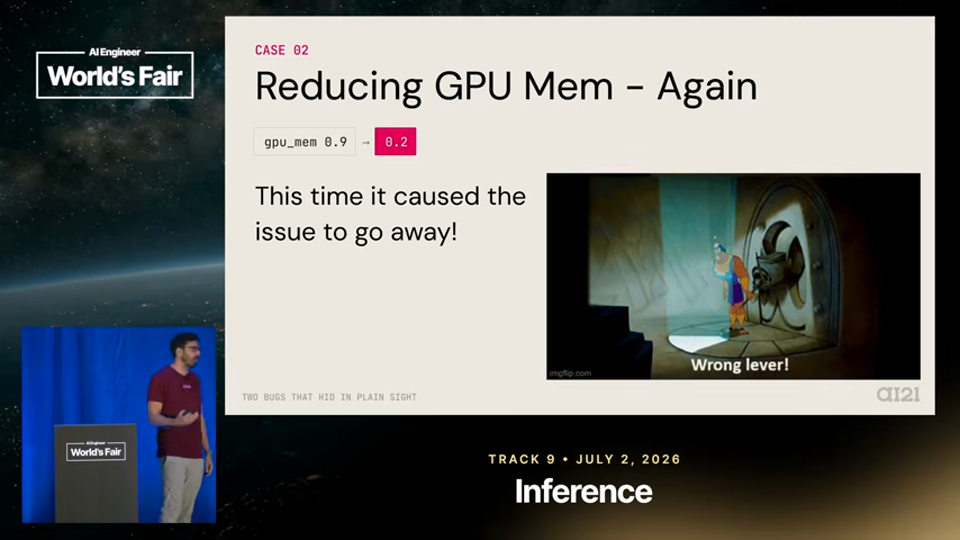
- 두 번째 오탐 — GPU 메모리 활용률을 0.9에서 0.2로 줄이자 문제가 사라져 처음엔 메모리 압박이 원인이라고 잘못 짚었다.
- 진짜 원인 — Mamba 커널이 쓰던 32비트 unsigned 인덱스가 40억을 넘어가며 랩어라운드된 것이 원인이었고, 메모리를 줄이면 버퍼가 작아져 그 지점에 도달하지 못했을 뿐이었다.
- 2차 수정 — 타입을 uint32에서 size_t(대부분의 최신 아키텍처에서 64비트)로 한 단어만 바꿔 오버플로가 다시는 발생하지 않게 했다.
그가 한 말
GPU 메모리 사용률을 90%에서 20%로 줄였습니다. 그러자 여러 요청을 동시에 실행했을 때 8854번 요청이 갑자기 횡설수설을 반환했습니다.we reduced it from 90% to 20%. And once we did that and then we started uh running a lot of requests uh simultaneously um all of a sudden request number let's say 8 854 suddenly returned gibberish4분 34초
커널이 잘못된 일을 한 게 아니라, 잘못된 시점에 잘못된 요청에 대해 호출된 것이었습니다.So the kernels weren't doing the wrong thing, they were called at the wrong time for the wrong requests.10분 13초
우리는 '이건 디코드 커널 문제다'라고 확신했습니다. 하지만 소프트웨어가 다 그렇듯, 너무 빨리 흥분했다가 그게 아니었다는 걸 알게 되죠.we were like okay it's got to be the decode kernels. But you know how it is in software you get excited too quickly and then you figure out it's not what happened.8분 1초
Mamba 커널이 32비트 부호 없는 정수 인덱스 포인터를 사용했다는 걸 알게 됐습니다. 오프셋이 40억을 넘어가면 에러를 던지는 대신 값이 랩어라운드됐습니다.we noticed that Mamba kernels um used um in 32 unsigned in 32 index pattern uh pointer. So, once the offset went past some you know 4 billion um uh numbers, it wrapped around instead of throwing an error.14분 22초
이해관계 · 발화자들은 발표 말미에 자신들이 발견한 내용을 정리한 블로그 글을 소개했다.
덧붙임 — 여기에 하나 덧붙이면, 두 사건 모두 "메모리를 줄이면 문제가 사라진다"는 실험 결과가 오히려 잘못된 원인으로 이어질 뻔했다는 점이 흥미롭다. 증상을 없애는 레버와 원인을 가리키는 레버는 다를 수 있다는 교훈이다.</note_ko> </invoke>
오늘 밤 해볼 수 있는 한 가지
자신의 추론 파이프라인에서 로그에 request ID가 forward pass 끝까지 남아있는지 확인해보고, 없다면 오늘 밤 간단한 컨텍스트 필드 하나를 추가해 요청 단위로 추적 가능하게 만들어본다.