Meta 추론 트래픽, 마이크로서비스 넘었다…병목은 모델 아닌 오케스트레이션
Meta의 추론(inference) 트래픽이 이미 세계 최대 규모 마이크로서비스를 넘어섰고, 회사가 운영해본 워크로드 중 가장 빠르게 성장하고 있다. Nishant Gupta와 Naman Ahuja는 이 흐름을 2008년 클라우드 초기와 비교하며, 지금 진짜 승부처는 최고의 모델이나 커널이 아니라 라우팅·KV 캐시·스케줄링을 아우르는 오케스트레이션 레이어라고 말한다.
- 2008년 비유 — 클라우드는 가상머신에서 시작해 스케줄러·서비스 메시·오토스케일러로 가치가 이동했고, AI도 같은 궤적을 몇 년으로 압축해서 밟고 있다.
- 에이전틱 수요 폭발 — 챗봇은 턴당 모델 호출 1회였지만 코파일럿은 10~20회, 리서치 에이전트는 50회, 자율 워크플로우는 수천 회에 달해 전통적 스프레드시트식 용량 계획이 통하지 않는다.
- 요청 형태 차이 — LLM 요청은 50토큰에서 10만 토큰까지 편차가 크고 프리필과 디코드 단계의 연산 프로파일이 완전히 달라 continuous in-flight batching 없이는 처리량이 한 자릿수 이상 떨어진다.
- GPU 비용 구조 — GPU는 CPU 대비 100배 비싸고 확보에 10배 더 오래 걸려 함부로 과잉 프로비저닝할 수 없다.
- 레이어 간 결합 — 라우팅 결정이 캐시 히트율을 바꾸고, 이는 배치 구성과 GPU 활용률, 나아가 오토스케일링 결정까지 연쇄적으로 바꾼다.
- 부분 실패 문제 — 200토큰을 이미 스트리밍한 상태에서 GPU가 선점(preempt)되면 단순 재시도가 불가능해 신뢰성은 전체 워크플로우를 보는 컨트롤 플레인에 있어야 한다.
- 스케줄러 7축 — 추론 스케줄러는 GPU 세대, 메모리 여유, KV 캐시 상태, 가중치 warm 여부, 테넌트 우선순위, 지연 예산, 워크플로우 맥락까지 7개 축을 동시에 봐야 한다.
- 5단계 중 3단계 — 5단계 워크플로우의 3단계가 실패하면 이미 1·2단계에서 쓴 비용까지 전부 낭비되므로 워크플로우 인지형 오케스트레이션이 필요하다.
- 최적화 4분면 — 모든 최적화는 캐싱으로 회피, 배칭으로 공유, 라우팅으로 이동, 어드미션 컨트롤로 지연이라는 4개 분면 중 하나에 속한다.
- 지표 전환 — 최적화해야 할 지표는 토큰당 비용이나 요청당 비용이 아니라 '성공한 작업당 비용(cost per successful task)'이다.
- 연쇄 장애 — GPU 하나가 저하되면 지연 상승, 클라이언트 재시도, 큐 깊이 증가, 정상 GPU 포화라는 피드백 루프가 이어져 지역 단위 장애로 번질 수 있다.
- 레이턴시-비용-처리량 삼각 — 배치 크기를 키우면 처리량과 비용 효율은 좋아지지만 테일 레이턴시가 나빠지는 등 세 지표를 동시에 잡을 수 없는 CAP 이론과 유사한 트레이드오프가 존재한다.
- 오케스트레이션 다음 단계 — 인프라의 다음 국면은 더 나은 모델이나 더 빠른 추론이 아니라 GPU·메모리·캐시를 자원으로 취급해 스케줄링·통제하는 오케스트레이션이라고 결론짓는다.
그가 한 말
LLM 서빙은 연속 인플라이트 배칭이 필요합니다. 그렇지 않으면 처리량이 한 자릿수 규모로 붕괴합니다.LLM serving requires continuous inflight batching how otherwise the throughput collapses by an order of magnitude3분 26초
모델 추론은 GPU에서 돌려야 하는데, 이는 (CPU보다) 100배 더 비싸고 확보하는 데 10배 더 오래 걸립니다.for model inferencing we require to run on GPUs which are 100 times more expensive which are 10 times slower to acquire3분 55초
병목은 모델 자체가 아니라 오케스트레이션 그 자체입니다.the bottleneck is not just the model, it's the orchestration itself4분 36초
토큰당 비용이나 요청당 비용만 최적화하는 것은 중요하지 않습니다. 우리는 성공한 작업당 비용을 최적화해야 합니다. 이것이 실제로 사용자가 신경 쓰는 것이기 때문입니다.it's not important to optimize just cost per token or cost per request. We have to optimize cost per successful task because this is what actually users care about12분 4초
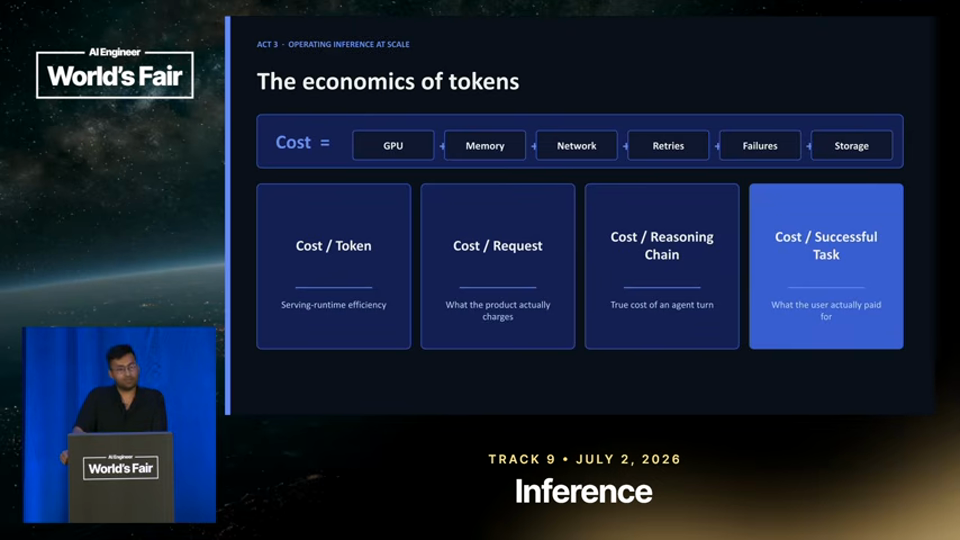
덧붙임 — 여기에 하나 덧붙이면, 이 발표가 강조하는 '비용은 토큰이 아니라 성공한 작업 단위로 재라'는 원칙은 에이전트형 제품을 만드는 팀 모두에게 곧바로 적용 가능한 측정 기준 전환이다. 다만 발표자들이 Meta 내부 사례를 일반화한 만큼, 실제 도입 난이도는 조직의 스케줄러·라우팅 성숙도에 따라 크게 갈릴 것이다.</note_ko> </invoke>
오늘 밤 해볼 수 있는 한 가지
오늘 밤, 운영 중인 LLM 서비스의 비용 지표를 '토큰당 비용' 대신 '성공한 작업 하나당 실제 비용'으로 다시 계산해 보라. 재시도·실패·부분완료 요청까지 포함시키면 숫자가 얼마나 달라지는지 확인하는 것만으로 병목 지점이 드러난다.