전화 통화의 20%는 동시발화, 음성 AI는 아직 무전기다
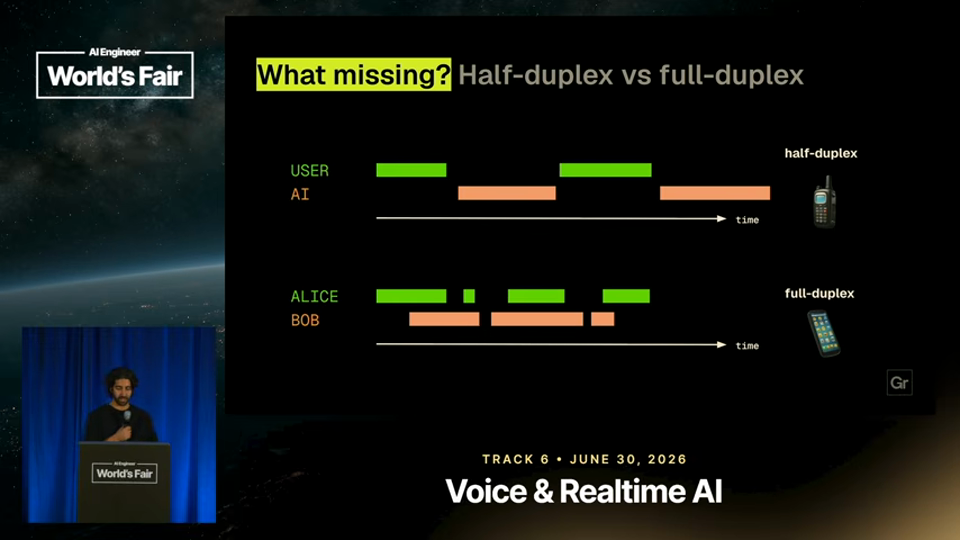
Gradium의 Neil Zeghidour는 오늘 나온 모든 실시간 음성 모델이 '듣거나 말하거나' 둘 중 하나만 하는 반이중(half duplex) 구조라고 지적한다. 인간은 통화 중 최대 20%의 시간을 동시에 말하는데, 이 자연스러움을 얻으려면 지능을 희생해야 한다는 것이 이 발표의 핵심 반전이다.
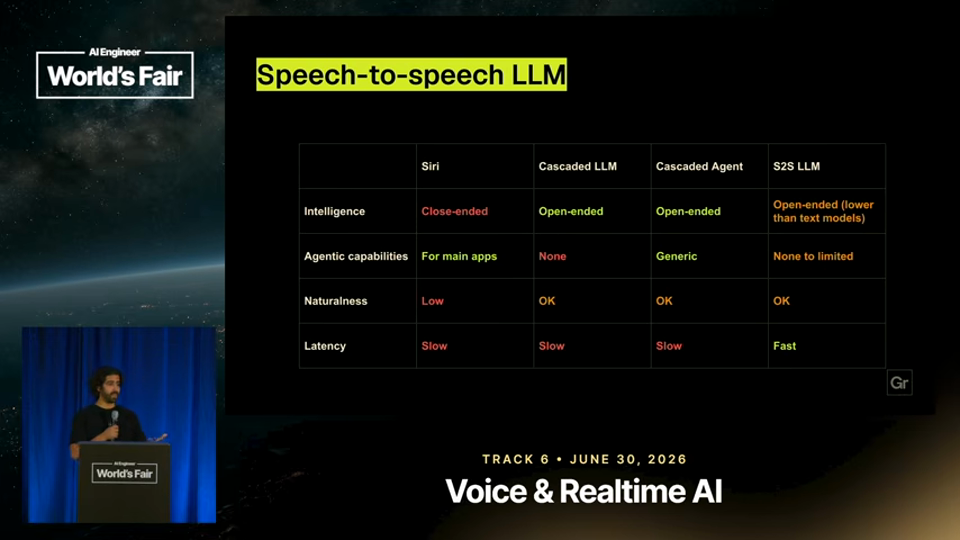
- Siri 2011 — 2011년 Siri는 LLM 없이 자연어이해로 트랜스크립트를 앱 액션에 매핑하는 폐쇄형 대화였다.
- 오픈엔디드 대화 — OpenAI의 초기 음성 모드는 대화는 자유로웠지만 날씨나 NASDAQ 같은 실제 행동을 수행하는 에이전트 능력은 없었다.
- 캐스케이드 에이전트 — 드라이브스루 봇 데모처럼 STT-LLM-TTS 파이프라인은 툴 호출과 추론으로 실제 주문을 처리하지만 텍스트를 거치며 톤과 감정 정보를 잃는다.
- 스피치투스피치 등장 — OpenAI의 어드밴스드 보이스 모드는 STT·LLM·TTS 세 단계를 하나로 흡수해 지연을 크게 줄였다.
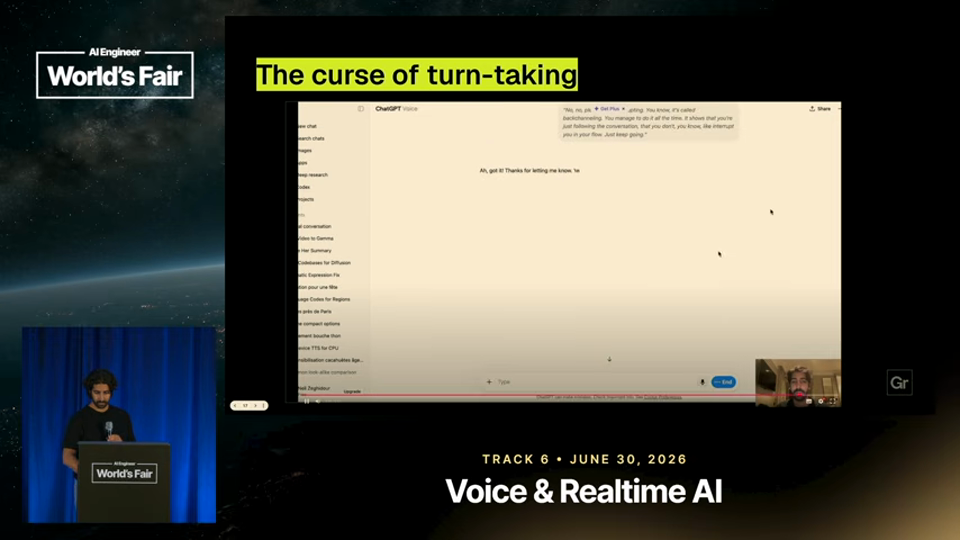
- 백채널링 실패 — Zeghidour가 라이브로 '음, 그래' 같은 백채널링을 하자 모델이 그때마다 대화를 멈추고 반응했다.
- 반이중의 한계 — 인간 통화에서는 최대 20%의 시간 동안 양쪽이 동시에 말하지만, 오늘의 모든 실시간 모델은 듣거나 말하거나 둘 중 하나인 half duplex다.
- 오디오의 비용 — 8단어 문장은 발음에 약 3초가 걸리고 24kHz에서 7만2000 타임스텝이 되는데, 어텐션 비용은 시퀀스 길이의 제곱에 비례해 처리 불가능할 정도로 커진다.
- 뉴럴 코덱 — 뉴럴 코덱(오디오 토크나이저)이 오디오를 압축된 토큰 표현으로 바꿔 텍스트처럼 LLM을 학습시킬 수 있게 한다.
- 멀티스트림 모델 — 두 개의 토큰 스트림을 동시에 모델링하는 멀티스트림 언어모델로 2024년 8월 Moshi를 통해 세계 최초의 완전 이중(full duplex) 음성 모델을 공개했다.
- 자연스러움 대 지능 — Moshi 같은 완전 이중 모델은 노이즈와 잡음 속에서도 대화 흐름이 끊기지 않지만, 캐스케이드 시스템보다도 지능이 떨어졌다.
- 용량의 트레이드오프 — 텍스트 모델이 음성을 이해·생성하도록 확장되면 모델 용량 일부가 음성 처리로 넘어가면서 그만큼 지능이 깎인다.
- 두 갈래 미래 — 하나는 스피치투스피치 모델 자체를 키우는 길, 다른 하나는 Moshi Vis 논문에서 제안하고 Thinking Machines도 재사용한 것처럼 작고 온디바이스인 자연스러움 담당 모델과 백그라운드 텍스트 모델을 분리하는 하이브리드 접근이다.
- 경제성 문제 — OpenAI의 어드밴스드 보이스 모드는 최근까지도 GPT-4o로 구동됐는데, 텍스트 모델이 여러 세대 발전하는 동안에도 교체하지 못할 만큼 스피치투스피치 모델 전환 비용이 크기 때문이다.
그가 한 말
가까운 사람과 통화할 때, 최대 20%의 시간 동안 둘 다 동시에 말하고 있습니다.If you're having a relative on the phone, there is up to 20% of the time where you are both speaking at the same time.9분 38초
스피치투스피치 모델은 텍스트 모델에 비해 근본적으로 여전히 지능이 제한적입니다.So, the speech-to-speech models are fundamentally still limited compared to the textual models.7분 44초
근본적으로 이는 턴테이킹 방식을 쓰는 한 해결될 수 없는 문제입니다.Fundamentally, this is uh an issue that can not be resolved when you're using turn-taking.9분 12초
그것은 이미 캐스케이드 시스템보다 지능이 떨어지는 스피치투스피치 모델보다도 더 멍청했습니다.it was even more stupid than speech-to-speech models that were already less intelligent than cascaded systems.13분 32초
이해관계 · 발화자 Neil Zeghidour는 음성 파운데이션 모델을 훈련하고 API로 판매하는 Gradium의 공동창업자 겸 CEO이며, 발표 말미 자사 제품 gradium.ai 이용과 채용을 직접 홍보했다.
덧붙임 — 여기에 하나 덧붙이면, 이 발표가 그리는 그림은 '완전 이중이 곧 정답'이 아니라 자연스러움과 지능이 같은 모델 용량을 두고 경쟁한다는 트레이드오프다. 결국 하이브리드 구조를 미는 이유도 기술적 우아함보다는 백엔드 모델을 자유롭게 교체하고 싶어하는 시장의 경제적 요구에 가깝다.
오늘 밤 해볼 수 있는 한 가지
지금 쓰는 음성 AI 서비스(챗봇 통화, 음성 비서 등)에 전화를 걸어 대화 중간에 '음, 그래' 하고 백채널링을 해본 뒤, 모델이 멈추는지 자연스럽게 흘려듣는지 직접 확인해본다.