30년 된 BM25가 830개 리들 벤치마크에서 다시 이긴 이유
검색 엔진 회사 Hornet.dev의 CEO Jo Kristian Bergum은 임베딩 모델이 아니라 30년 전 스코어링 함수인 BM25가 에이전트 검색에서 다시 강력해지고 있다고 말한다. 함수는 그대로인데, 검색을 하는 사용자가 사람에서 LLM으로 바뀌면서 게임의 규칙이 달라졌다는 주장이다.
- BM25 정의 — BM25는 Best Match 25의 줄임말로, 여러 실험 중 25번째 스코어링 방식이 가장 좋아서 이름이 그대로 굳어졌다.
- 에이전트 검색 3요소 — 에이전트 검색을 잘 만들려면 툴을 쓸 수 있는 모델, 검색 기능을 노출하는 하니스, 대규모 문서를 처리하는 검색 엔진 세 가지가 필요하다.
- 더 강력해진 사용자 — BM25 자체는 바뀌지 않았지만 엔티티·회사·날짜를 이미 아는 LLM이 사용자가 되면서 훨씬 강력한 쿼리를 던질 수 있게 됐다.
- BrowseComp Plus — 약 10만 개 웹 문서에 대한 830개의 퀴즈형 질문으로 구성된 딥리서치 벤치마크 BrowseComp Plus를 소개했다.
- 컨텍스트=플로피디스크 — 1980년대 플로피디스크가 1.4메가바이트였듯, 현재 모델도 품질이 저하되기 전까지 약 35만 토큰이 한계라고 비유했다.
- 정답 직접 넣으면 — 답을 담은 문서를 컨텍스트에 그대로 넣으면 GPT-4 같은 구형 모델도 정확도가 매우 높아, 추론 자체는 병목이 아니었다.
- 검색 툴을 주면 하락 — 같은 모델에 검색 툴만 쥐어주면 쿼리 작성 능력과 검색기 성능에 의존하게 되면서 정확도가 떨어진다.
- AOL 쿼리 로그 비교 — AOL 쿼리 로그에서 사람들은 두세 단어로 검색했고, 최근 사람 쿼리 로그도 여전히 비슷한 반면 GPT-5는 사이트 연산자 등 훨씬 길고 구체적인 쿼리를 쓴다.
- 어떤 BM25인가 — BrowseComp Plus 원 논문이 쓴 BM25 하이퍼파라미터가 긴 문서에 부적합했고, 파라미터를 바꾸면 정확도가 크게 달라진다.
- BM25가 유리한 이유 — 모델이 이름·우편번호·SKU 같은 정확 일치 대상을 이미 알고 있고, 임베딩 추론보다 비용이 저렴하며, 매칭 결과를 모델이 스스로 검증하기 쉽다.
- 워크스페이스 확장 논문 — Waterloo 대학 Jimmy Lin 그룹의 'dynamic workspace expansion' 논문을 인용하며, 검색 결과를 파일시스템처럼 조직해 점진적으로 공개하는 방식을 소개했다.
- 처리량 비교 — 1억 개 웹 문서를 단일 노드에서 처리하는 실험에서 Hornet의 구현이 다른 익명 처리된 엔진들보다 지연시간이 낮았다고 밝혔다.
그가 한 말
BM25는 원래 일종의 베이스라인 함수였습니다. 어떤 정보 검색 연구든 BM25 베이스라인을 포함시키고, 그다음 뭔가 멋진 고급 뉴럴 방식을 넣어서 BM25와 비교하곤 했죠.BM25 used to be a kind of a baseline function. Any information retrieval research would include a BM25 baseline and then you would put something fancy advanced neural fancy stuff and then you would compare it with BM25.3분 54초
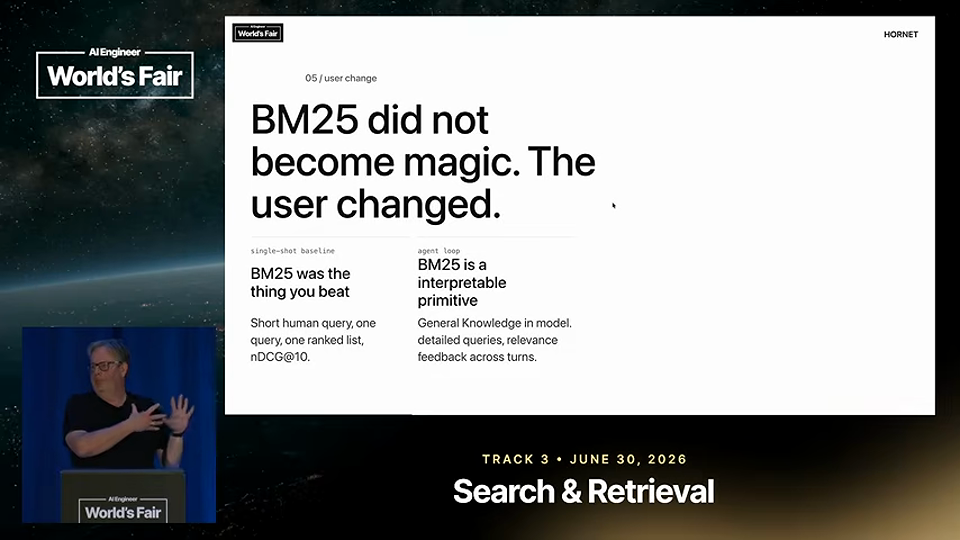
그런데 알고 보니 그 베이스라인이 형편없었습니다. 그래서 임베딩 모델 같은 더 화려한 기법들을 보면 원 논문 기준으로는 BM25보다 훨씬 나은 검색 방식처럼 보이죠. 하지만 최근 연구에 따르면 browsecomp plus 논문에서 쓴 파라미터가 이런 긴 문서를 다루기엔 적절하지 않았던 것으로 나타났습니다.it turns out that that baseline is terrible. So when you look at fancier techniques, embedding models, what have you, um it's stands out as a much better retrieval paradigm than BM25 if you look at the original paper. But more recent research shows that the parameters that were used in the browse comp plus research paper was not really adequate to handle these kind of long documents.9분 52초
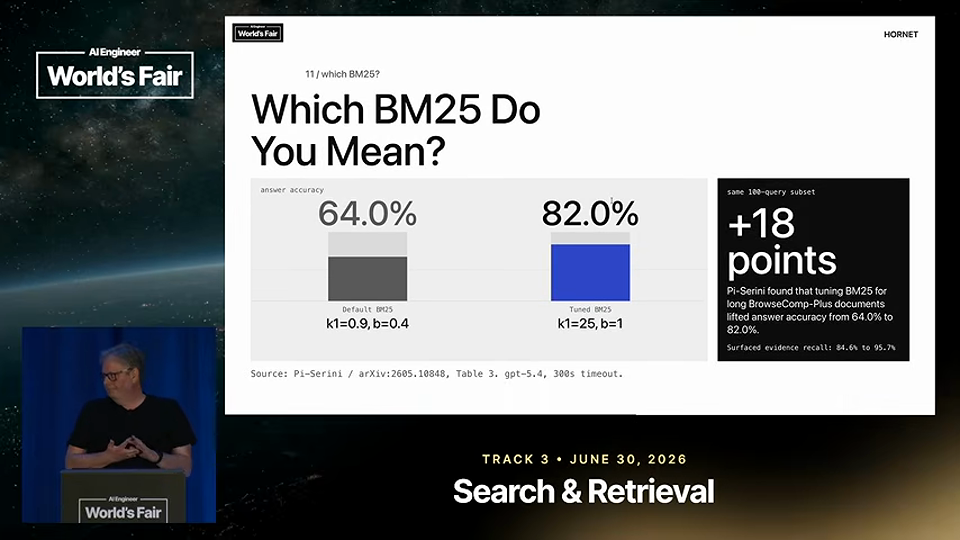
질문에 답하는 데 필요한 증거 문서를 인위적으로 모델의 컨텍스트 윈도우에 채워 넣으면 정확도가 매우 높습니다. 즉 추론이 병목이 아니라는 뜻이죠.if you artificially just stuff the evidence documents that is needed to answer this question into the context window of the model the accuracy is really high right so reasoning is not the bottleneck6분 53초
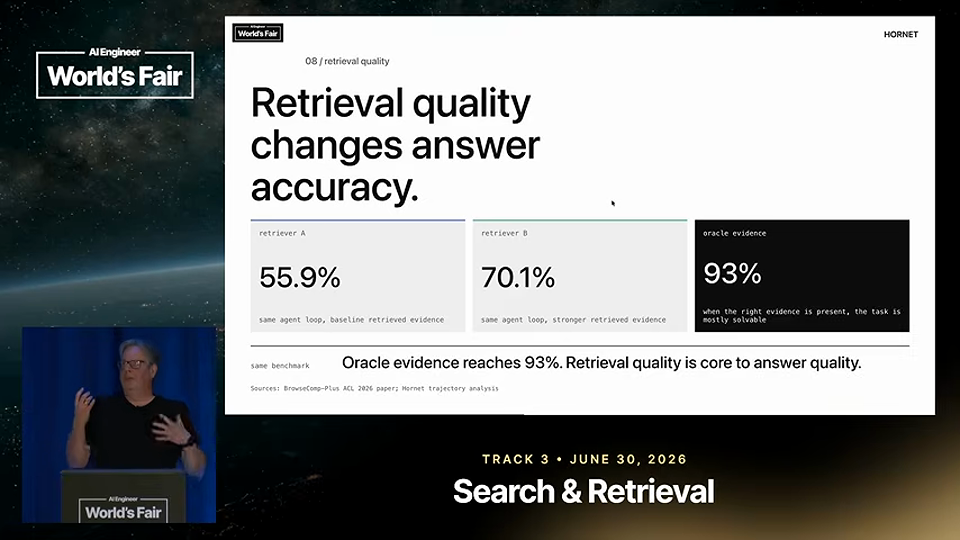
하지만 모델에게 검색 도구가 딸린 하네스를 붙여주면 정확도가 떨어집니다. 이제는 하네스에, 즉 모델의 질의 작성 능력과 리트리버의 검색 품질에 좌우되기 때문이죠.but if you expose the model with a harness with a retrieval tool. That accuracy falls because it now depends on the harness. It depends on the model's ability to formulate queries and the retrieval quality of the retriever.7분 15초
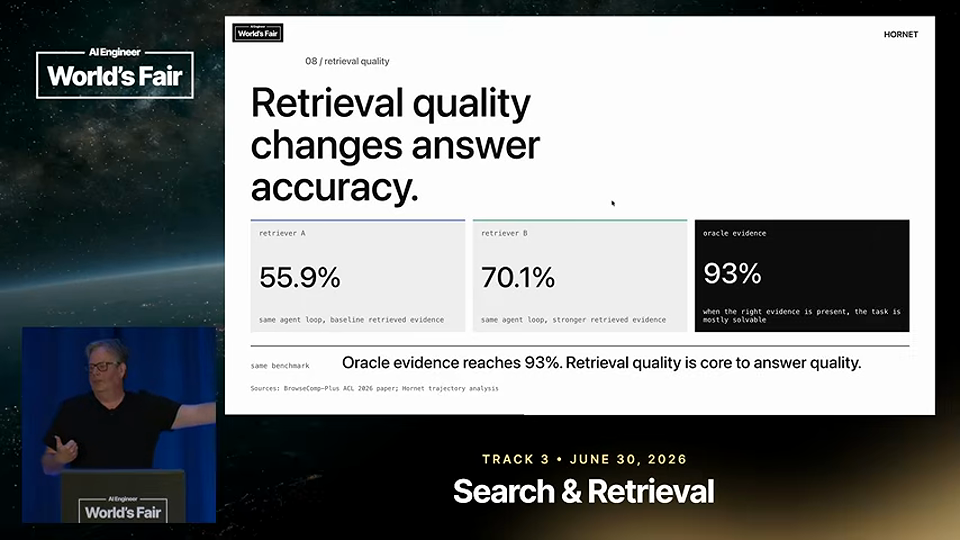
이해관계 · 발화자는 검색·검색 인프라 회사 Hornet.dev의 CEO로, 발표에서 자사 제품(Hornet)의 성능 비교 결과를 직접 소개했다.
덧붙임 — 여기에 하나 덧붙이면, 이 이야기의 핵심은 BM25가 더 똑똑해졌다는 게 아니라 검색을 던지는 주체가 사람에서 지식을 이미 아는 모델로 바뀌었다는 데 있다. 검색 품질 논쟁은 앞으로 알고리즘보다 '어떤 파라미터의 BM25인지', '컨텍스트에 무엇을 채울지'를 결정하는 하니스 설계 쪽으로 옮겨갈 가능성이 크다.
오늘 밤 해볼 수 있는 한 가지
지금 쓰고 있는 RAG나 에이전트 검색 파이프라인에서 임베딩 검색 대신 기본 BM25(파라미터 조정 포함)로 바꿔 같은 질문 10개에 대한 정확도를 30분간 비교해 보라.