짧은 메시지 지연 13배 개선, TCP 대신 Homa 쓰는 이유
AI 워크로드가 거대한 그래디언트 전송에서 KV 캐시 조회, 배리어 동기화 같은 짧고 빈번한 메시지로 옮겨가면서 TCP와 RDMA의 설계 전제가 무너지고 있다. Stanford의 John Ousterhout는 clean-slate 프로토콜 Homa로 짧은 메시지의 99번째 백분위수 지연을 TCP 대비 13배 줄였다고 밝혔다.
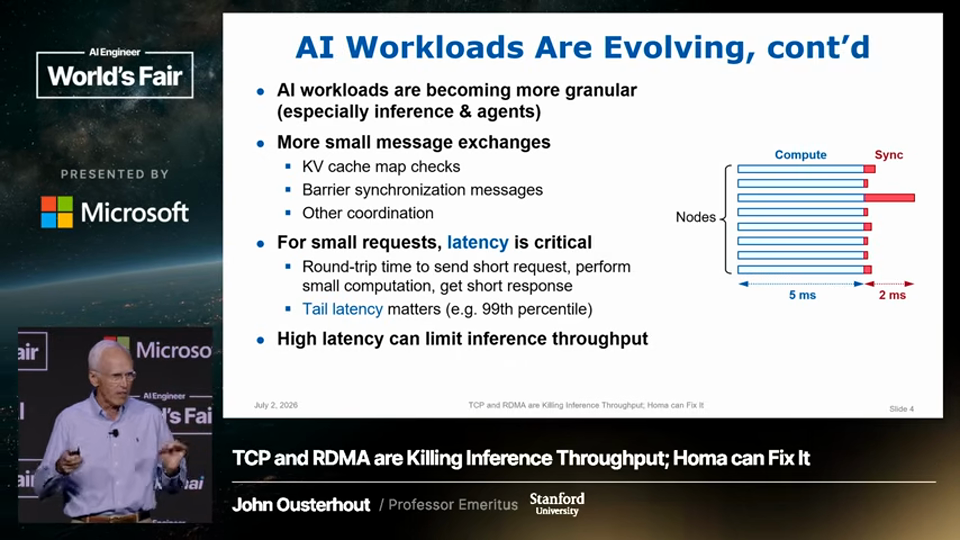
- 워크로드 변화 — 과거 AI 트래픽은 그래디언트 같은 기가바이트 단위 대형 전송이 지배적이었지만, 추론·에이전트 워크로드는 KV 캐시 조회나 배리어 동기화 같은 작은 메시지 교환 위주로 바뀌고 있다.
- 핵심 지표는 테일 레이턴시 — 작은 메시지에서 중요한 건 평균 지연이 아니라 99번째 백분위수 같은 테일 레이턴시이며, 이는 전체 시스템 처리량을 제한한다.
- GPU 유휴 문제 — 연산 단계가 5초일 때는 문제없었지만 에이전트 워크로드에서 연산 주기가 밀리초 단위로 줄면서 동기화에 걸리는 밀리초가 GPU 자원의 상당 부분을 낭비시킨다.
- 인캐스트로 인한 정체 — 여러 노드가 동시에 한 목적지로 전송하면 top-of-rack 스위치의 목적지 포트 큐에 패킷이 쌓이고, 짧은 메시지가 긴 메시지 뒤에 갇혀 버퍼 오버플로와 재전송까지 유발한다.
- 송신자 기반 혼잡 제어의 한계 — TCP와 RDMA는 혼잡 제어 책임을 송신자에게 두는데, ECN 마킹 같은 신호가 여러 왕복(round trip)을 거쳐야 전달되기 때문에 시스템이 안정화되지 못하고 계속 진동한다.
- 바이트 스트림의 한계 — TCP는 메시지 경계를 모르는 순수 바이트 스트림이라 짧은 메시지를 우선 처리할 수 없고, 긴 메시지 뒤에 짧은 메시지가 갇히는 head-of-line blocking이 발생한다.
- Homa의 탄생 — Homa는 Stanford에서 개발된 clean-slate 전송 프로토콜로, 원래 박사과정 학생 Benam Montazeri의 박사 논문에서 시작해 Ousterhout이 직접 Linux 커널 모듈로 구현해 GitHub에 공개하고 커널 업스트림 작업을 진행 중이다.
- 메시지 기반 설계 — Homa의 기본 단위는 요청·응답으로 이뤄진 RPC이며, 메시지 길이 정보를 전송 계층 끝까지 유지해 SRPT(shortest remaining processing time first) 방식으로 짧은 메시지를 우선시킨다.
- 수신자 기반 혼잡 제어 — Homa는 수신자가 grant 패킷을 보내 다음 데이터 전송 시점을 통제하는 방식으로 혼잡을 제어하며, 첫 패킷만으로 전체 메시지 크기를 알기 때문에 훨씬 빠르고 정확하게 대응한다.
- 스위치 우선순위 큐 활용 — 최신 데이터센터 스위치가 제공하는 8개 우선순위 큐를 활용해 짧은 메시지를 상위 큐로 보내 긴 메시지에 밀리지 않고 목적지에 먼저 도달하게 한다.
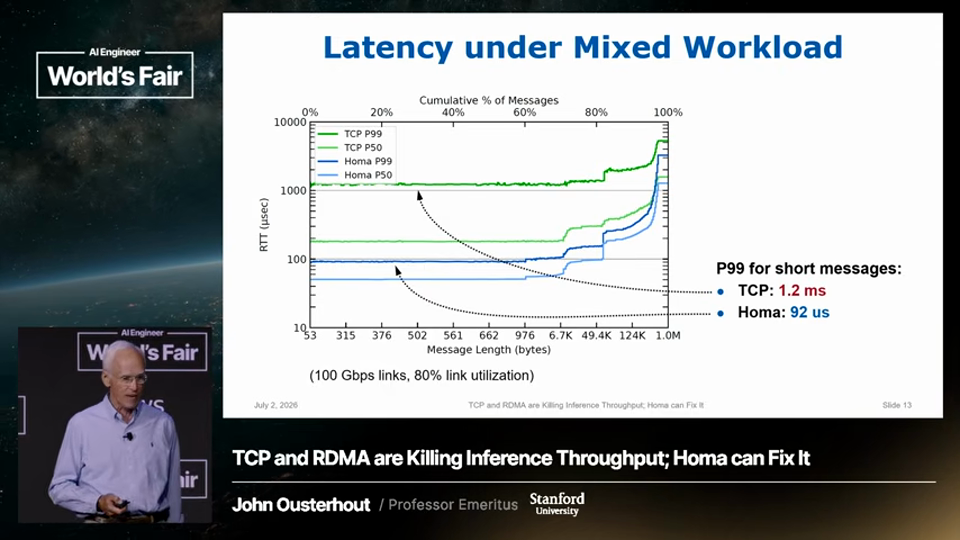
- 벤치마크 결과 — 50바이트에서 1메가바이트까지의 메시지 벤치마크에서 짧은 메시지의 P99 지연이 TCP는 1밀리초 이상인 반면 Homa는 100마이크로초 미만으로 약 13배 빨랐고, 가장 긴 메시지에서도 Homa가 TCP보다 약 2배 나은 성능을 보였다.
그가 한 말
TCP는 꼬리 지연시간이 1밀리초가 넘습니다. 호마는 100마이크로초 미만으로, 약 13배 빠릅니다.So with TCP it's more than a millisecond tail latency. Home is less than 100 microsconds about 13 times faster.16분 36초
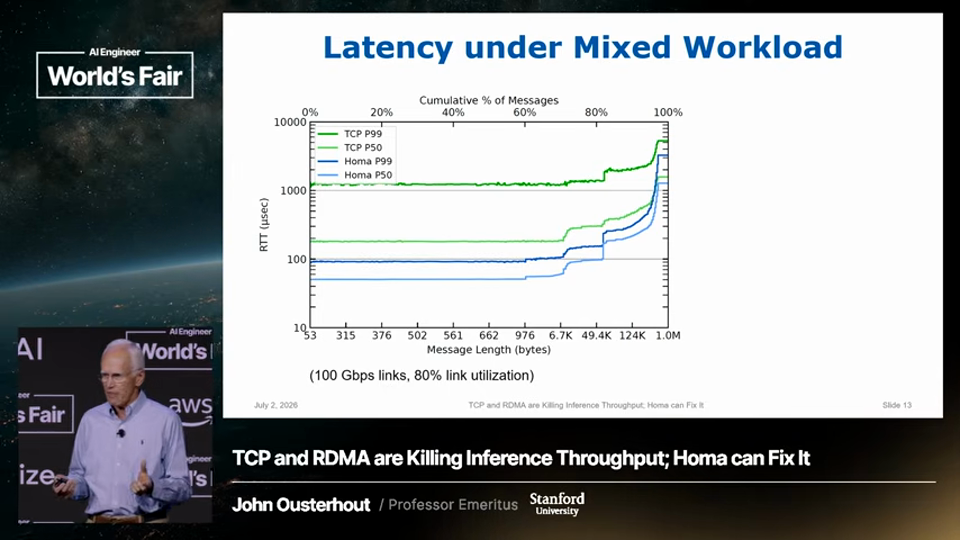
가장 긴 메시지에서도 호마는 TCP보다 거의 2배 더 낫습니다.Even on the longest messages, Hom is almost a factor of two better than TCP.16분 56초
궁금해서 그런데, 간단히 청중 설문을 해보고 싶습니다. 여기 계신 분들 중 작은 메시지의 지연시간이 애플리케이션 전체 처리량에 영향을 미친다고 믿을 근거가 있는 분 계신가요?So I'm curious. I'd like to just do a a quick audience poll here. Is there anybody here where you have reason to believe that the latency of small messages is impacting the overall throughput of your applications?5분 21초
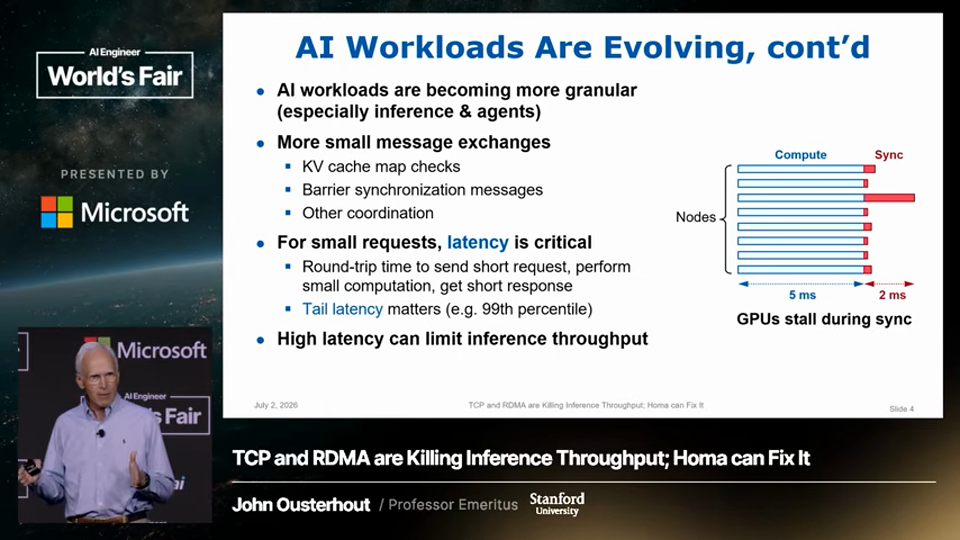
다음 연산 단계로 넘어가기 전에 그 모든 교환이 완료되어야 합니다.You need all of those exchanges to complete before you can go on to the next phase of computation.4분 43초
이해관계 · Ousterhout는 현재 Stanford에서 반퇴직 상태로 Homa 개발에 전념 중이며, 청중에게 Homa 도입 시 직접 지원(질문 답변, 버그 수정 등)을 제공하겠다고 밝혔다.
덧붙임 — 여기에 하나 덧붙이면, 이 발표는 트레이닝이 아니라 추론·에이전트 워크로드에서의 병목을 겨냥한다는 점을 분명히 해야 한다. 대형 전송 위주 학습 환경이라면 TCP·RDMA 교체의 실익이 크지 않을 수 있다.
오늘 밤 해볼 수 있는 한 가지
GitHub에서 Homa의 Linux 커널 모듈을 내려받아 README의 벤치마크 스크립트로 자신의 테스트 환경에서 짧은 메시지 P99 지연을 TCP와 비교해본다.