P99 100ms가 20초로, 파티션 4000개의 함정
Legora는 법률 문서 검색 인프라를 세 차례 갈아엎었다. 마지막 붕괴는 스키마에는 보이지 않는 "패킹 문제"에서 왔다. 죽은 프로젝트와 살아있는 프로젝트가 같은 파티션에 묶이면서 캐시가 통째로 흔들렸고, 해법은 결국 프로젝트 하나를 저장의 최소 단위로 만드는 것이었다.
- Legora가 하는 일 — Legora는 로펌과 사내 법무팀이 계약 검토, 계약서 작성, 법률 리서치를 협업하는 AI 플랫폼이다.
- 두 종류의 검색 — 프로젝트 검색은 수십 건에서 수백만 건 문서로 구성된 단일 프로젝트 내 검색이고, 법률 리서치는 법령·판례·규정 전체를 훑는 딥리서치형 워크로드다.
- 1단계 - 단일 클러스터 — 처음엔 모든 테넌트가 하나의 거대한 Elasticsearch 클러스터와 하나의 블록 스토리지를 공유했다.
- 2단계 - 지역별 분리 — 미국·유럽·호주 고객이 각자 자국 내 처리를 요구하면서 전체 스택을 EU·US·APAC 세 벌로 그대로 복제했다.
- 3단계 - Postgres 이전 — 대형 은행·로펌의 물리적 격리와 고객관리형 암호화키(CMEK) 요구에 맞춰 pgvector와 tsvector 기반 Postgres로 옮기며 문서 청크를 4000개 파티션에 빈패킹했다.
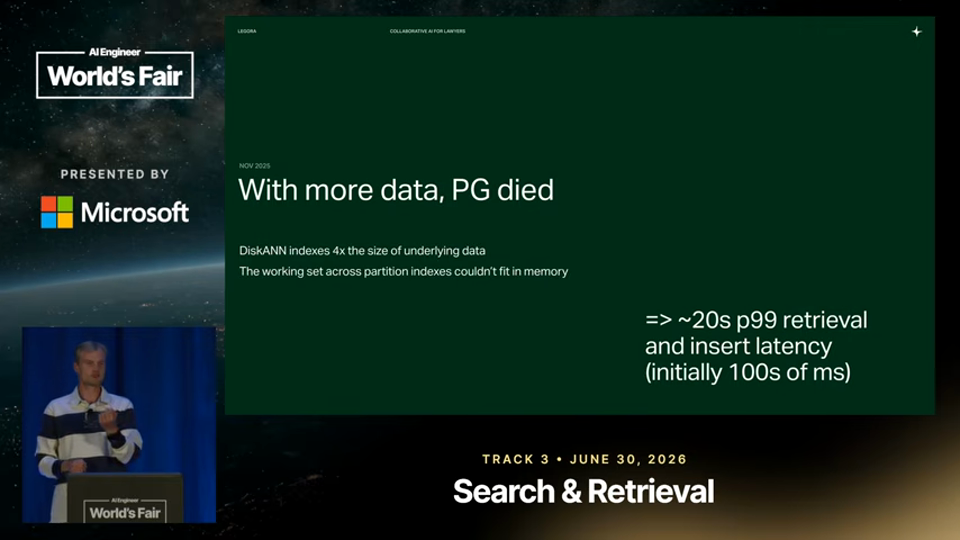
- 붕괴의 원인 — 휴면 프로젝트와 활성 프로젝트가 같은 파티션에 섞이면서 파티션이 거대해졌고, 쿼리마다 큰 파티션을 메모리에 올리고 직전 것을 쫓아내며 캐시를 계속 스래싱했다.
- 레이턴시 붕괴 수치 — 검색·색인 P99가 100밀리초에서 20초로 치솟았다.
- turbopuffer로 이전 — 약 4억 건 문서 규모에서 프로젝트당 하나의 네임스페이스로 turbopuffer에 옮기며 진짜 BM25와 더 낮은 레이턴시, 단일 클러스터 운영을 얻었다.
- 네임스페이스와 암호화 — turbopuffer는 네임스페이스를 원자 단위로 삼아 각 네임스페이스마다 다른 암호화 키와 다른 버킷을 쓸 수 있고, 일부 고객은 수천 개의 버킷에 네임스페이스를 나눠 갖는다.
- SSD 캐시를 끈 실험 — SSD 캐시에 암호화를 구현하는 대신 아예 캐시를 꺼서 성능을 측정했더니 메모리 캐시만으로도 충분히 좋아 일부 Legora 워크로드에서 그대로 유지했다.
- 라운드트립 최소화 — S3의 1메가바이트 블록 P99가 약 200밀리초이기 때문에 turbopuffer는 쿼리당 약 3회의 라운드트립으로 끝내도록 설계됐다.
- 법률 리서치 확장 — 법률 리서치 코퍼스는 100억 벡터를 향해 커지고 있으며, 관할권별로 네임스페이스를 나눠 EU법처럼 뜨거운 데이터는 캐시에, 덴마크법처럼 거의 조회되지 않는 데이터는 블록에 그대로 둔다.
- 결과 — turbopuffer 전환 후 중간값 레이턴시가 한 자릿수 개선됐고 P99는 더 크게 개선됐으며, Legora는 70개 이상 테넌트를 개별 Elasticsearch 없이 운영한다.
그가 한 말
그래서 검색 및 인덱싱 P99 지연이 100밀리초에서 20초로 늘어났는데, 상상할 수 있듯이 정말 나쁜 사용자 경험이었습니다.So we went from like search and ingestion P99 of 100 milliseconds into 20 seconds, which you can imagine is a really bad user experience.6분 15초
그래서 약 4억 개 문서 정도였을 때 터보퍼퍼로 옮겼고, 터보퍼퍼에서는 프로젝트당 하나의 네임스페이스로 구성했습니다.So then we went to turbopuffer in about you know when we're about I think 400 million documents something like that and what we did with turbopuffer was we did one name space per project6분 20초
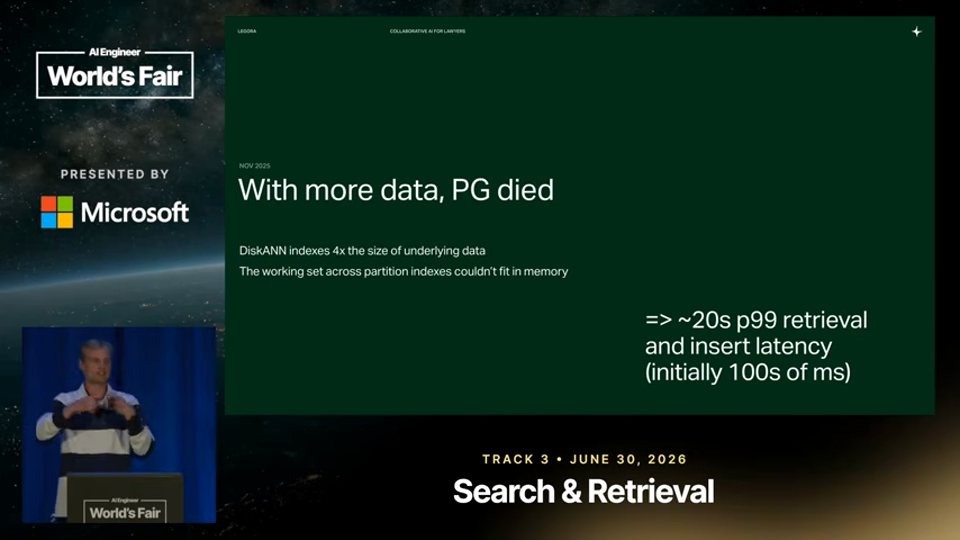
디스크 캐시에 암호화를 구현하려고 했지만, 대신 그냥 디스크 캐시를 꺼버리고 어떻게 되는지 지켜봤는데, 메모리 캐시만으로도 터보퍼퍼 성능이 너무 좋아서 그냥 그 상태로 두었습니다.what we did was that we thought we were going to implement encryption into the disc cache but instead we just disabled the disc cache and saw how it fared and the performance of turbopuffer even without the disc cache with just the memory cache was so good that we just kept it that way10분 47초
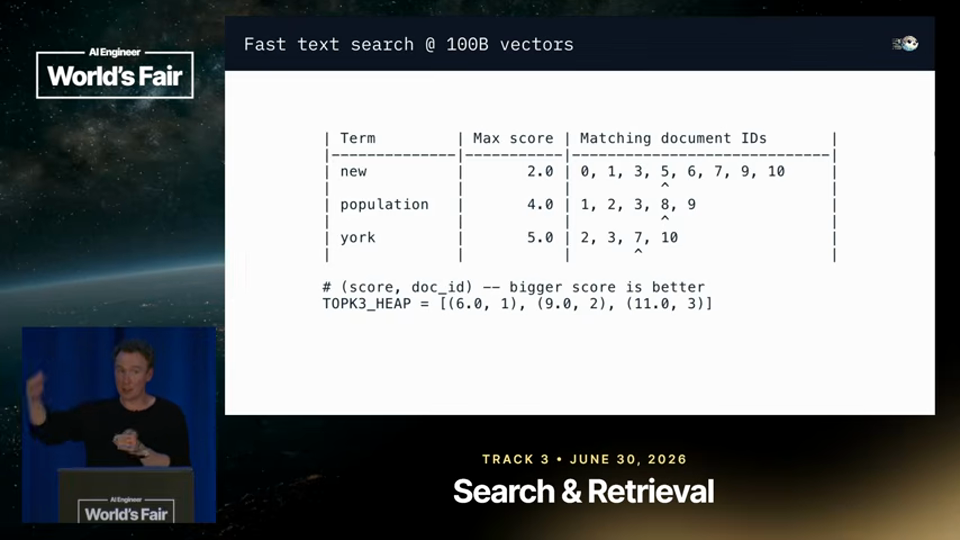
대부분의 사람들에게는 직관에 반하겠지만, 웹 규모의 텍스트 검색이 벡터 검색보다 더 어렵고 계산 비용이 더 많이 듭니다.counterintuitively to most people, text search at web scale is more difficult and more computationally expensive than doing vector search.18분 52초
이해관계 · Simon Eskildsen는 발표에서 소개한 검색 엔진 turbopuffer의 공동창업자 겸 CEO이며, Jacob Lauritzen은 turbopuffer 고객사인 Legora의 엔지니어로 두 사람 모두 자사·거래사 제품을 설명하는 위치에 있다.
덧붙임 — 여기에 하나 덧붙이면, 이 사례의 핵심은 turbopuffer라는 도구 자체보다 "저장 단위를 실제 사용 패턴과 일치시켰다"는 설계 판단에 있다. 파티션을 아무리 정교하게 쪼개도 접근 빈도가 다른 데이터를 억지로 같은 그릇에 담으면 캐시는 결국 깨진다.
오늘 밤 해볼 수 있는 한 가지
지금 운영 중인 데이터베이스에서 접근 빈도가 극단적으로 갈리는 두 종류의 레코드(예: 활성 사용자 vs. 휴면 계정)가 같은 파티션이나 샤드에 섞여 있지 않은지 30분간 쿼리 로그로 확인해본다.</action_ko>
</invoke>