음성 에이전트 데이터 수집, 정확도 30%에서 95%로 끌어올린 방법
지난 1년간 언어모델 지능 향상은 대부분 '더 오래 생각하기'에서 나왔지만, 음성 에이전트는 그 사고 기능을 꺼야 한다. 사용자가 말을 끝내고 에이전트가 답하기까지 주어진 시간은 수백 밀리초뿐이기 때문이다. 월 10억 통 이상의 통화를 처리해온 Plivo 창업자 Venky B가 데모에서 프로덕션으로 넘어갈 때 실제로 무너지는 다섯 가지 지점을 짚었다.
- 레이턴시 체감 — 대부분 팀이 550ms 미만을 목표하지만 실제로는 750~1200ms에 머물고, 그보다 늦으면 사용자가 전화를 끊는다
- 사고 기능은 꺼야 한다 — 지난 1년 LLM 지능 향상은 대부분 thinking·강화학습에서 왔는데, 음성 에이전트는 빠르게 답하려면 이 thinking을 기본적으로 꺼야 해 발전분이 거의 적용되지 않는다
- 프런티어 모델의 한계 — OpenAI·Claude·Gemini 같은 프런티어 모델은 p50 TTFT가 450~500ms지만 p90/p95는 1.2~1.3초까지 튄다
- 전용 인프라의 비용 — Cerebras나 Groq에서 전용 지연시간을 확보하려면 전용 용량이 필요한데, 이들 팀은 12개월치 예약이 이미 끝나 있다고 말한다
- 오픈소스 자체 호스팅 — Qwen 3.5와 Gemma 4를 자체 호스팅해 300ms 미만을 지속적으로 달성하는 것이 비용·지능·지연시간 균형에 가장 현실적이었다
- 언어별 토큰 효율 — 다국어에서는 Gemma가 Qwen 3.5보다 토큰 효율(단어당 토큰 수)이 최소 2.5~3배 좋다
- 모델 크기 선택 — 파인튜닝 없이 쓸 거면 3~4B MoE로 90%까지 도달하지만, 특정 도메인을 파인튜닝하려면 최소 8B~12B급이 필요하다
- 전사(transcrip — 전사(transcription)의 취약성 — 최신 전사 엔진도 알려진 평가셋에서 단어 오류율 4~6%이고, 실제 잡음 섞인 통화·억양·도메인 어휘에서는 두 자릿수까지 치솟는다
- 코드 스위칭 붕괴 — 힌디어가 영어 스크립트로 들어오는 식의 코드 스위칭 언어는 전사부터 LLM, TTS까지 전 구간을 연쇄적으로 망가뜨린다
- 데이터 수집이 최대 실패 지점 — AI 에이전트의 50~60%가 데이터 수집 단계에서 크게 망가진다고 본다
- 필드 타입으로 재정의 — 전화번호를 자유 텍스트가 아닌 길이·검증 규칙이 있는 타입 필드로 다루자 데이터 수집 정확도가 30%에서 95~97%로 뛰었고, 파인튜닝은 필요 없었다
- TTS 정규화 계층 — LLM 출력을 TTS에 바로 보내지 않고 이모지·마크다운 제거, 고유명사 발음 사전, 특정 단어 구간에서 0.7~0.8배속 낭독 같은 정규화 계층을 자체로 둬야 한다
- 발음 테스트 사례 — 자신의 성 'Balasubramanion'과 회사명 'Plivo'를 제대로 발음하지 못하면 이미 기준 미달이라고 본다
그가 한 말
바로 이 지점에서 AI 에이전트의 50~60%가 심각하게 망가진다고 생각합니다.This is where I think 50 to 60% of AI agents mess up pretty badly.17분 49초
그런 식으로 접근하기 시작하면 데이터 수집 정확도가 30%에서 95% 수준까지 올라가는 것을 봤습니다.we have seen accuracy grow up from grow from 30% to like 95% from a data collection standpoint when you start thinking in that manner.18분 25초
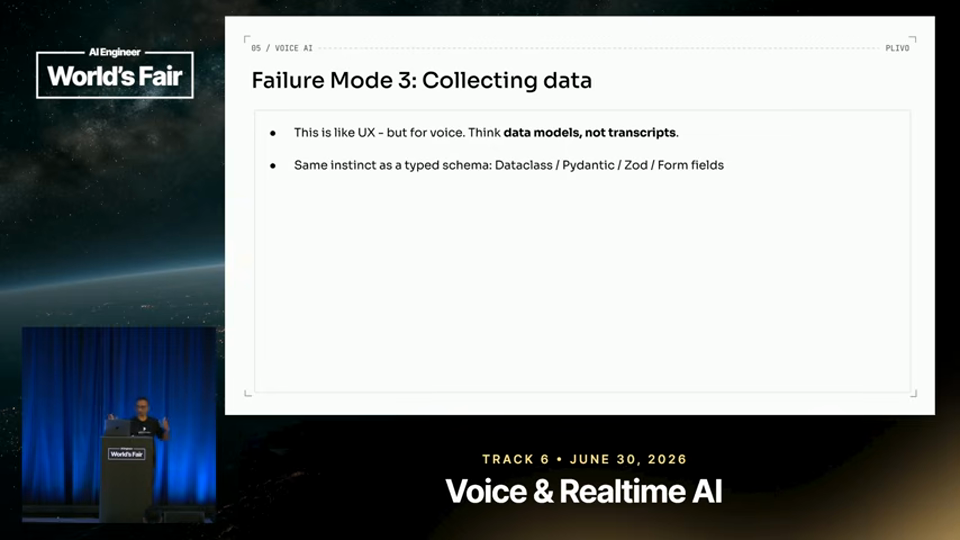
거의 항상 말하는 LLM이나 에이전트는 사고(thinking) 기능을 꺼야 합니다. 그래서 지난 1년간 LLM 계층에서 이룬 발전들이 사실상 여기서는 전혀 적용되지 않습니다.almost always your the the LLM or the agent that's talking has to have thinking turned Right. So all the advancements we've had in the LLM layer in the last one year like none of that even apply here now.6분 54초
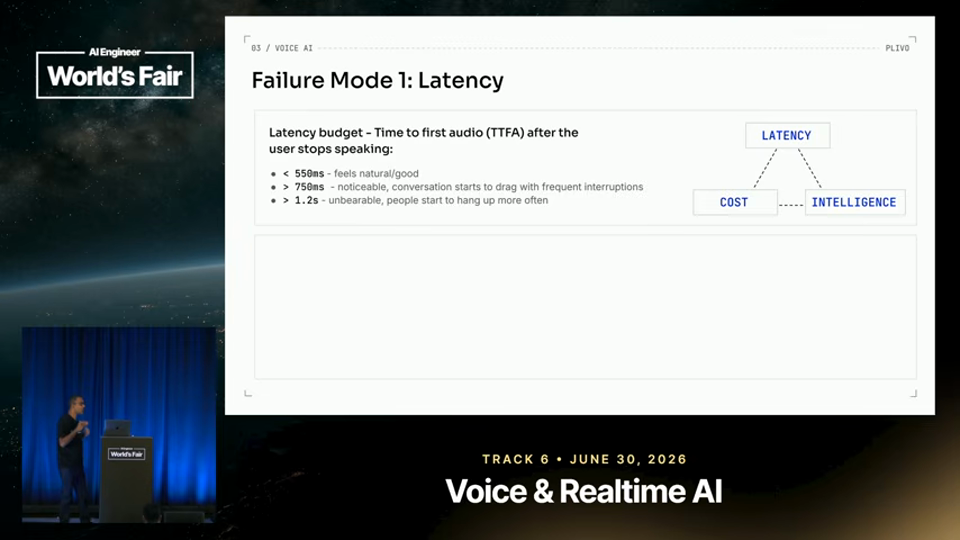
시중 최고 수준의 전사 엔진도 알려진 평가 세트에서는 단어 오류율이 4~6% 정도지만, 실제 억양이 다르거나 도메인 용어가 섞인 노이즈 많은 실제 통화에서는 보통 두 자릿수 오류율로 올라갑니다.the state-of-the-art transcription engines out out in the market u you know sort of get you to four to 6% word error rate right and this is on known eval sets on real world noisy calls with you know sort of uh accents like people having different sort of accents uh domain vocabulary and so on and so forth like those usually end up in the double digits from a word erate perspective right13분 39초
이해관계 · 발화자는 자신이 창업자·CEO로 있는 음성 AI 인프라 기업 Plivo의 제품과 운영 경험을 근거로 발표했다.
덧붙임 — 여기에 하나 덧붙이면, 발표 전반을 관통하는 메시지는 결국 '프롬프트로 때우지 말고 타입 시스템으로 풀라'는 것이다. 전화번호를 자유 텍스트 전사 결과로 다루던 팀이 필드 타입으로 바꾸자 정확도가 3배 뛴 사례는, 음성 AI 실패의 상당수가 모델 문제가 아니라 데이터 구조 설계 문제였다는 점을 보여준다.
오늘 밤 해볼 수 있는 한 가지
지금 운영 중이거나 만들고 있는 음성 에이전트에서 전화번호·이메일·날짜처럼 자유 텍스트로 받는 필드 하나를 골라, 길이·형식 검증 규칙이 있는 타입 필드로 바꾸고 단위 테스트 형태로 정확도를 따로 측정해본다.