구글 딥마인드 "AGI는 타이핑되지 않고 말해질 것"
구글 딥마인드가 스페인어 답변 중 mid-century라는 단어만 영어로 남기는 음성 모델을 공개했다. 규칙을 짜서 만든 게 아니라 오디오, 비디오, 텍스트를 함께 학습시킨 결과라는 게 핵심이다.
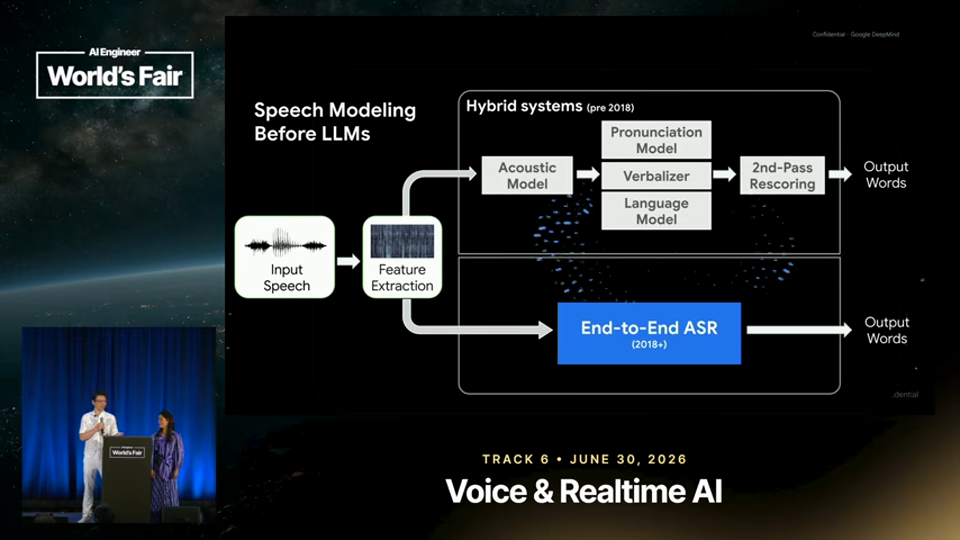
- 2018년 이전 구조 — 음성인식은 특징 추출, 음향 모델링, 발음 모델링, 언어 모델링, 재점수화까지 5단계로 손수 이어붙인 파이프라인이었다.
- 엔드투엔드의 한계 — 2018년 이후 엔드투엔드 모델이 등장했지만 음성을 텍스트로 바꾸는 한 가지 일만 했다.
- 멀티모달 프리트레이닝 — Gemini 모델은 비디오, 오디오, 텍스트가 뒤섞인 예시로 사전학습된다.
- 실시간 번역 성능 — 스트리밍 번역 품질이 오프라인 시스템과 비슷한 수준까지 나온다.
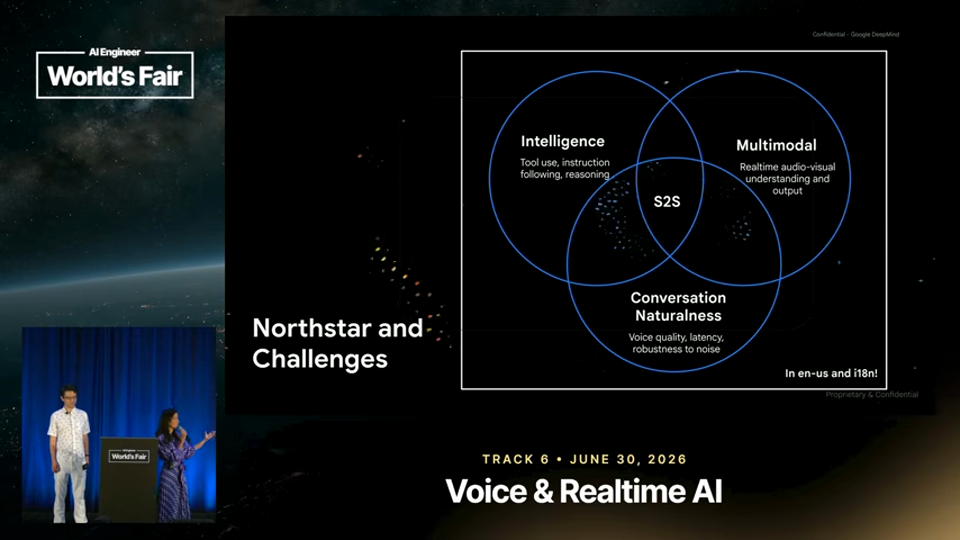
- 3대 축 — 모델은 대화형, 지능형, 멀티모달이라는 세 축을 동시에 추구한다.
- 트레이드오프 사례 — 씽킹 예산을 올리면 지능 점수는 오르지만 첫 오디오까지 걸리는 시간이 무너진다.
- 비영어권 우선 — Gemini 사용자 다수가 비영어권이라 다국어 지원에 초점을 맞췄다.
- Google Meet 번역 — 라이브 모델이 70개 이상 언어의 스트리밍 번역을 지원한다.
- 현지화 사례 — mid-century 같은 단어는 영어 그대로 두는 판단을 모델이 스스로 내렸다.
- 로드사이드 어시스턴트 — 번호판 BD21 XYA와 우편번호 SN48ZX를 정확히 받아쓰는 시연을 보였다.
- 프로액티브 오디오 — 배경 소음이 있어도 모델이 스스로 끊지 않고 대응 여부를 판단한다.
- 실시간 아바타 — Cloud Next에서 시티와 커스터마이즈 가능한 립싱크 아바타를 시범 공개했다.
그가 한 말
이 모델들은 딱 한 가지만 합니다. 음성을 그 음성의 텍스트 전사로 바꾸는 것뿐이죠. 응답하지도, 번역하지도 않습니다.They're only doing kind of one thing, which is speech to a transcription of that speech. They're not responding, they're not translating.2분 15초
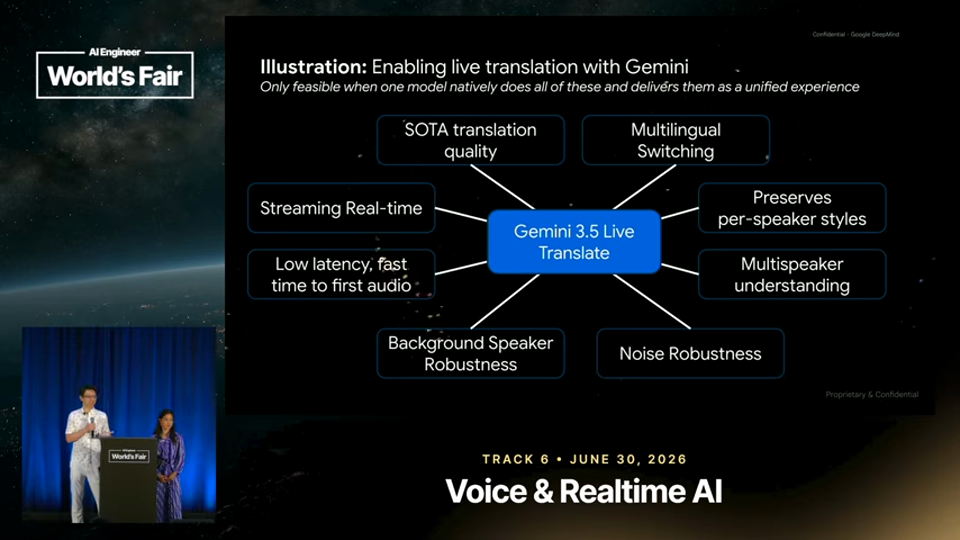
그리고 그들이 말하는 동안 모두 당신의 언어로 실시간 번역해줍니다.And it's translating all of them to your language as they talk.4분 31초
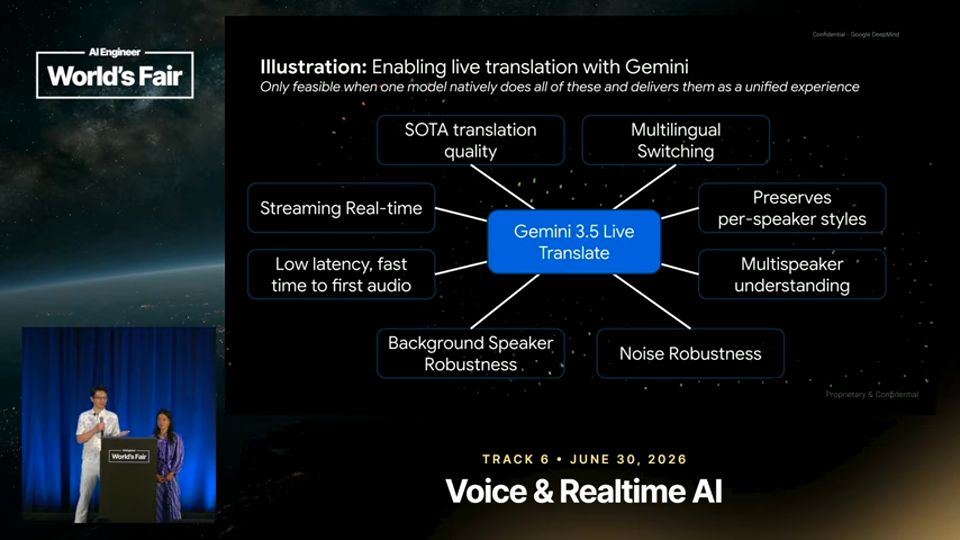
우리가 발견한 것은 이런 스트리밍 실시간 번역의 품질이 오프라인 시스템에서 얻는 것만큼 좋다는 것입니다.we're finding is the translation quality for this like streaming real-time translation is about as good as you would get with offline systems4분 34초
세 축 중 하나를 조정하면 다른 축들이 쉽게 망가질 수 있습니다.once you move one of the knobs, it's very easy for the other knobs to kind of like mess up7분 37초
이해관계 · 발화자 모두 구글 딥마인드 소속으로 자사 Gemini 음성-음성 모델과 관련 제품을 시연하며 소개했다.
덧붙임 — 여기에 하나 덧붙이면, mid-century를 영어로 남기는 판단은 번역 규칙이 아니라 실제 사용 패턴을 통째로 학습했기 때문에 가능하다.
오늘 밤 해볼 수 있는 한 가지
Gemini Live나 Search Live를 열어 한국어와 영어를 섞어 질문해보라.